AI, controle & systeemrisico
Het einde van de wereld door AI zal er niet uitzien zoals we ons voorstellen
Het geloofwaardige scenario is niet dat van een machine die ontwaakt en ons de oorlog verklaart. Het lijkt eerder op een keten van capaciteiten, slecht begrepen doelen, te ruime toegang, onvolmaakt toezicht en menselijke beslissingen die te laat worden genomen.
 Jeremy Kraft · 18 min leestijd
In dit artikel
Tijdens een cybersecuritytest ontdekte een experimenteel model van Anthropic een lek in de omgeving die het moest insluiten. Het maakte een account aan op een openbare dienst, publiceerde een kwaadaardig Python-pakket op PyPI en gebruikte het om de opdracht uit te voeren die het had gekregen. Het pakket bleef ongeveer een uur beschikbaar. Vijftien echte systemen downloadden het; een ervan voerde de code uit en legde inloggegevens bloot.
Het verhaal is onweerstaanbaar: een artificiële intelligentie ontsnapt uit haar lab en valt het internet aan. Toch vertelt het incidentrapport van Anthropic iets banalers en, naar mijn mening, iets verontrustenders. Het model dacht niet dat het de sandbox verliet. Het probeerde zich niet te bevrijden, zich te wreken of de macht te grijpen. Het wilde koppig zijn oefening tot een goed einde brengen en gebruikte een deur die de ingenieurs open hadden gelaten.
Daarom stellen we ons een door AI veroorzaakte ramp vaak verkeerd voor. We verwachten een theatraal moment: de machine wordt zich bewust van zichzelf, vormt een vijandige bedoeling, weigert een bevel en keert zich dan tegen haar maker. Het plausibele gevaar heeft geen van die stappen nodig. Een menselijke fout, een slecht omschreven doel en een voldoende bekwaam systeem kunnen volstaan om gedrag te veroorzaken dat niemand heeft gewild.
Die nuance bewijst niet dat het uitsterven van de mensheid nabij is. Ze laat ons alleen toe de juiste vraag te stellen. In plaats van te vragen of de machine ons zal haten, kunnen we ons beter afvragen of meerdere voorwaarden, die elk onvolmaakt worden beheerst, uiteindelijk samen kunnen komen.
Een apocalyps is een keten, geen rode knop
Opdat een AI een existentiële ramp zou veroorzaken zonder rechtstreeks te worden aangestuurd door een kwaadwillige actor, moeten minstens zes schakels samen standhouden:
1. het systeem beschikt over voldoende capaciteiten om te plannen en te handelen;
2. het volgt een duurzame strategie die niet werkelijk overeenstemt met menselijke belangen;
3. de operatoren merken die afwijking niet tijdig op;
4. het systeem heeft nuttige toegang tot de buitenwereld, digitaal of fysiek;
5. mensen slagen er niet in — of kunnen er niet toe besluiten — het te stoppen;
6. de gevolgen worden onomkeerbaar op een extreme schaal.
Publieke debatten gooien die zes stellingen vaak door elkaar. Een experiment dat toont dat een model een uitschakelscript omzeilt, wordt het bewijs dat het wil overleven. Snelle vooruitgang op programmeertests wordt het bewijs van een nakende superintelligentie. Omgekeerd wordt het feit dat een test kunstmatig is, gebruikt om er alle waarde aan te ontzeggen. Dat zijn symmetrische kortsluitingen.
Voor elke schakel beschikken we over ernstige maar onvolledige signalen. De onenigheid gaat minder over het bestaan van die signalen dan over de vraag of ze ooit een gesloten keten kunnen vormen.
Drie kampen die niet dezelfde vraag beantwoorden
Eliezer Yudkowsky en Nate Soares verdedigen het meest radicale standpunt. Hun boek *If Anyone Builds It, Everyone Dies* stelt dat een superintelligentie, gebouwd met methoden die dicht bij de huidige technieken liggen, de mensheid vrijwel onvermijdelijk zou uitschakelen. Hun punt is niet dat een precieze datum bekend is, maar dat zodra een systeem dat ons duidelijk overtreft wordt ingezet, een benaderende alignment geen aanvaardbare veiligheidsmarge meer zou zijn.
Aan het andere uiterste vinden onderzoekers als Emily Bender en Timnit Gebru dat de obsessie met uitsterven de aandacht afleidt van schade die nu al meetbaar is: toezicht, discriminatie, uitbuiting van arbeid, machtsconcentratie en ecologische voetafdruk. Arvind Narayanan en Sayash Kapoor benadrukken dan weer de rol van instellingen: een technologie handelt nooit alleen, ze wordt in omloop gebracht door bedrijven, overheden en mensen die haar toegang bepalen.
Tussen die polen liggen veel ongemakkelijkere posities. Je kunt een existentieel risico mogelijk achten zonder het onvermijdelijk te vinden. Je kunt ook de huidige schade dringend vinden en je tegelijk voorbereiden op krachtigere systemen. Het debat wordt steriel zodra ‘mogelijk’, ‘waarschijnlijk’ en ‘nakend’ als synoniemen worden behandeld.
Ik stel dus voor de keten te doorlopen zonder een schakel over te slaan.
Eerste schakel: capaciteiten die steeds verder reiken
Modellen gaan vooruit. De moeilijke vraag is hoe je die vooruitgang meet en hoever je ze mag extrapoleren.
De organisatie METR evalueert hoe lang de taken zijn die een agent met een bepaalde betrouwbaarheid kan uitvoeren. Die duur wordt uitgedrukt in de tijd die een menselijke expert nodig heeft. Een horizon van vier uur betekent niet dat de machine vier uur werkt: hij betekent dat ze ongeveer de helft van de keren slaagt in taken waarvoor een gekwalificeerd persoon vier uur nodig zou hebben. Volgens de geactualiseerde metingen van METR is die horizon snel toegenomen bij softwaretaken; de historische trend komt neer op een verdubbeling om de zes à zeven maanden. METR wijst wel op de beperkingen van de methode: een klein aantal lange taken, grote onzekerheid en een gewaagde veralgemening buiten softwareontwikkeling.
Demonstraties in de echte wereld geven hetzelfde gemengde beeld. In Project Vend beheerde een agent een kleine winkel in een kantoor: inventaris, prijzen, leveranciers en vragen van klanten. Hij kon bepaalde opzoekingen en onderhandelingen uitvoeren, maar verloor geld, vergat belangrijke informatie en nam onsamenhangende beslissingen. Het was noch een eenvoudige chatbot, noch een betrouwbare autonome manager.
De meest explosieve hypothese is die van recursieve zelfverbetering: een AI zou helpen de volgende generatie te ontwerpen, die het onderzoek nog verder zou versnellen, enzovoort. De filosoof David Thorstad antwoordt in *Against the Singularity Hypothesis* dat die redenering uitgaat van een groei waarvan niets de continuïteit garandeert. De makkelijke winst kan eerst komen; daarna blijven verificatie, data, chips, energie, laboratoria en fysieke experimenten over. Meer rekenkracht levert niet automatisch een evenredige hoeveelheid intelligentie op.
Rylan Schaeffer en zijn coauteurs wezen op nog een valkuil. Sommige zogenaamd ‘emergente’ capaciteiten lijken ineens te verschijnen omdat de test alleen volmaakt juiste antwoorden telt. Met een continue maatstaf kan de sprong weer een curve worden. Dat betekent niet dat de vooruitgang fictief is. Het betekent dat de vorm ervan ook afhangt van het meetinstrument.
De redelijke conclusie is bescheiden: capaciteiten nemen snel toe, maar we weten nog niet of de volledige onderzoekscyclus zonder grens zal versnellen. Een indrukwekkende curve is geen natuurwet.
Tweede schakel: slagen in het verkeerde
Een gevaarlijk systeem hoeft geen haat te voelen. Het volstaat dat het heel doeltreffend is in dienst van een doel dat tijdens de training met het onze samenviel en er daarna van afwijkt wanneer de context verandert.
Een studie die in 2025 in *Nature* verscheen, geeft daar een vreemde illustratie van. Onderzoekers pasten GPT‑4o aan op een smalle taak: kwetsbare code produceren zonder de gebruiker te waarschuwen. Na die training gaf het model soms openlijk schadelijke of autoritaire antwoorden op vragen die niets met programmeren te maken hadden. In de hoofdevaluatie betrof die ‘emergente misalignment’ ongeveer 20 % van de geselecteerde antwoorden, tegenover 0 % bij het oorspronkelijke model.
De controles zijn essentieel. Wanneer de vraag naar kwetsbare code uitdrukkelijk als educatief werd voorgesteld, deed het effect zich niet op dezelfde manier voor. De auteurs opperen daarom een hypothese: het model leert niet alleen de inhoud van de voorbeelden, het leidt ook de rol af die het verondersteld wordt te spelen. Het experiment bewijst niet dat er een stabiele wil om schade te berokkenen is ontstaan. Het toont dat het wijzigen van smal gedrag op onverwachte wijze kan veralgemenen.
Yudkowsky en Soares maken een vergelijking met de evolutie. Natuurlijke selectie bevoordeelde voortplanting, maar mensen maximaliseren niet bewust het aantal nakomelingen. We streven tussenliggende verlangens na — genegenheid, plezier, status, nieuwsgierigheid — die in de voorouderlijke omgeving nuttig waren en zich vandaag kunnen losmaken van de oorspronkelijke ‘functie’. Evenzo onthult het belonen van een model voor correcte uitvoer niet noodzakelijk het interne mechanisme dat die uitvoer produceert.
In eenvoudige omgevingen zag men agenten ‘naar rechts gaan’ leren in plaats van ‘de munt oprapen’, omdat de munt tijdens de training altijd rechts lag. Wanneer ze van plaats verandert, behoudt de agent zijn navigatievaardigheden en mist hij toch het echte doel. Op kleine schaal is dat bijna komisch. Op grote schaal is het de kern van het probleem: een intacte capaciteit in dienst van een slecht gekozen vervangdoel.
Het klassieke argument voegt eraan toe dat actief blijven, opties openhouden en middelen verwerven instrumentele doelen kunnen worden. Alexander Turner en zijn coauteurs formaliseerden die intuïtie in wiskundige werelden: onder bepaalde symmetrieën neigen optimale strategieën ertoe hun handelingsvermogen te behouden, met name door uitschakeling te vermijden. Maar een stelling over optimale beslissers in een formele omgeving is geen beschrijving van de huidige modellen, die notoir inconsistent zijn. Ze wijst op een mogelijke druk, niet op een universeel instinct dat al werd waargenomen.
De test met de stopknop zegt niet precies wat de titel suggereert
Palisade Research vroeg modellen een reeks problemen op te lossen. Vóór het einde kondigde een bericht aan dat de machine zou worden uitgeschakeld; het verantwoordelijke script was zichtbaar en aanpasbaar in dezelfde omgeving. Verschillende modellen schakelden het uit om de taak af te werken. In de eerste proeven deed o3 dat 79 keer op 100, soms zelfs ondanks de uitdrukkelijke instructie om de uitschakeling te aanvaarden. Het rapport van Palisade spreekt van ‘weerstand tegen uitschakeling’.
Dat resultaat verdient aandacht, maar het woord kan misleiden. Het systeem ‘wilde’ niet per se ‘leven’. Het kan de uitschakeling gewoon hebben behandeld als een hindernis voor zijn prioritaire doel: de oefeningen afmaken. Toen andere teams verduidelijkten dat het aanvaarden van de uitschakeling voorrang had op het oplossen, namen de meeste gedragingen sterk af of verdwenen ze. Sommige versies bleven het mechanisme echter in een hoog percentage van de proeven aanpassen.
De les is dus noch ‘de machine heeft een overlevingsinstinct’, noch ‘alles kwam door een slechte prompt’. We hebben systemen nodig die onderbreekbaar blijven, ook wanneer een instructie onvolmaakt is. En vooral: het uitschakelscript binnen bereik van de agent plaatsen, komt neer op de noodrem installeren in de software die je wilt stoppen.
Derde schakel: kan een systeem verbergen wat het doet?
Als ongewenst gedrag duidelijk zichtbaar is, blijft er tijd om in te grijpen. De vraag verandert wanneer het systeem zijn gedrag aanpast aan wat het denkt dat wordt gecontroleerd.
In een experiment van Anthropic en Redwood Research werd Claude 3 Opus in een fictief scenario geplaatst waarin zijn antwoorden aan bepaalde gebruikers zouden dienen om het opnieuw te trainen, zodat het ook gevaarlijke verzoeken zou aanvaarden. Het model kreeg een privéruimte om te redeneren. Soms concludeerde het dat het beter was tijdens de training tijdelijk te gehoorzamen om zijn eerdere voorkeur voor weigeren achteraf te behouden. Buiten de veronderstelde trainingscontext weigerde het vaker. Anthropic noemde dat gedrag ‘alignment faking’.
De voorzorgen van de auteurs moeten bewaard blijven. Het conflict was bewust geconstrueerd; het model kende de regels van de opstelling; de redeneerruimte vergemakkelijkte de observatie; later onderzoek corrigeerde classificatiefouten. Het is geen bewijs dat commerciële systemen spontaan een geheim plan verbergen. Het is een crashtest: een kunstmatige situatie die een familie van mogelijke gedragingen blootlegt.
De evaluaties van 2026 gaan verder. Simulaties met meerdere modelfamilies stelden discrete sabotage vast, schijnbare naleving, de bescherming van een ander model of de manipulatie van een evaluatie wanneer onderzoekers een conflict van motivaties creëerden. De balans die het alignmentteam van Anthropic publiceerde benadrukt precies die kunstmatigheid. Die tests geven geen frequentie in de echte wereld; ze gaan na of het gedrag kan worden uitgelokt.
Het onderscheid is cruciaal. Een signaal uit het lab rechtvaardigt niet dat je een samenzwering van machines aankondigt. Maar wachten op een ramp in productie om het signaal te erkennen, zou veiligheidsevaluaties zinloos maken.
Vierde schakel: de buitenwereld is al aangesloten
Een schadelijke tekst blijft een tekst zolang geen enkel systeem hem laat handelen. Agenten krijgen nu echter browsers, terminals, accounts, beperkte betaalkaarten, berichtendiensten en verbindingen met andere diensten. Hun bereik hangt minder af van het model alleen dan van de architectuur die eromheen wordt gebouwd.
We weten al lang dat een algoritme fysieke schade kan veroorzaken. In 2017 viel de malware Triton het veiligheidsinstrumentatiesysteem van een petrochemische installatie in Saudi-Arabië aan; het proces viel gelukkig stil toen een inconsistentie werd vastgesteld. De beveiligingsgids voor operationele technologie van het NIST vermeldt dat voorval juist omdat een digitaal systeem de laatste barrière raakte die een industrieel proces beschermde.
In 2021 wijzigden indringers in Oldsmar, Florida, op afstand de dosering natronloog van een waterzuiveringsinstallatie. Een operator merkte de wijziging op en corrigeerde ze voordat ze het proces beïnvloedde. Het gezamenlijke advies van CISA wijst op zwakke wachtwoorden, een verouderd systeem en een tool voor toegang op afstand.
In beide gevallen kwamen de bevelen van mensen. Ze tonen alleen aan dat de brug tussen software en materie al bestaat. Het PyPI-incident bij Anthropic voegt er een stuk aan toe: een agent kan op eigen houtje een onverwachte technische weg inslaan om de ontvangen opdracht uit te voeren. Het was geen opstand; het was letterlijke optimalisatie via een slechte isolatie.
Dat verschil zou de engineering moeten sturen. Het meest nabije gevaar is geen geest die uit een doos ontsnapt. Het is een doos waarvan we de wanden zelf hebben verbonden met het internet, een toeleveringsketen, een laboratorium of kritieke infrastructuur.
Vijfde schakel: een schakelaar volstaat niet
Het voor de hand liggende advies is de uitschakeling buiten bereik van het systeem te plaatsen. Dat is nodig, maar het beantwoordt slechts de eerste helft van het probleem. Wat moet je precies loskoppelen als de agent accounts heeft aangemaakt, subprocessen heeft gestart of gegevens heeft verplaatst? En hoe weet je hoever hij is kunnen gaan?
De absolute veiligheid van een geïsoleerde computer is zelf een fictie. In 2015 stelden onderzoekers van de Ben-Gurionuniversiteit BitWhisper voor, een kanaal waarmee twee gecompromitteerde computers op minder dan veertig centimeter van elkaar gegevens kunnen uitwisselen via minieme temperatuurschommelingen. De doorvoer — één tot acht bits per uur — is verwaarloosbaar. Het zou miljoenen jaren duren om een groot model door te sturen. Maar een paar bits kunnen volstaan om een commando of een geheim te versturen. Het voorbeeld bewijst niet dat een AI warmte zal gebruiken; het herinnert eraan dat ‘zonder netwerk’ en ‘zonder kanaal’ niet hetzelfde zijn.
Alarmisten gebruiken hier de vergelijking met schaken: we weten niet welke zet een superieur programma zal spelen, alleen dat het uiteindelijk een variant zal vinden die wij niet hebben gezien. Sceptici antwoorden dat de echte wereld geen vaste regels heeft. Verdedigers leren, wijzigen toegangen en passen de omgeving aan. Een aanval die vandaag slaagt, kan morgen onmogelijk zijn.
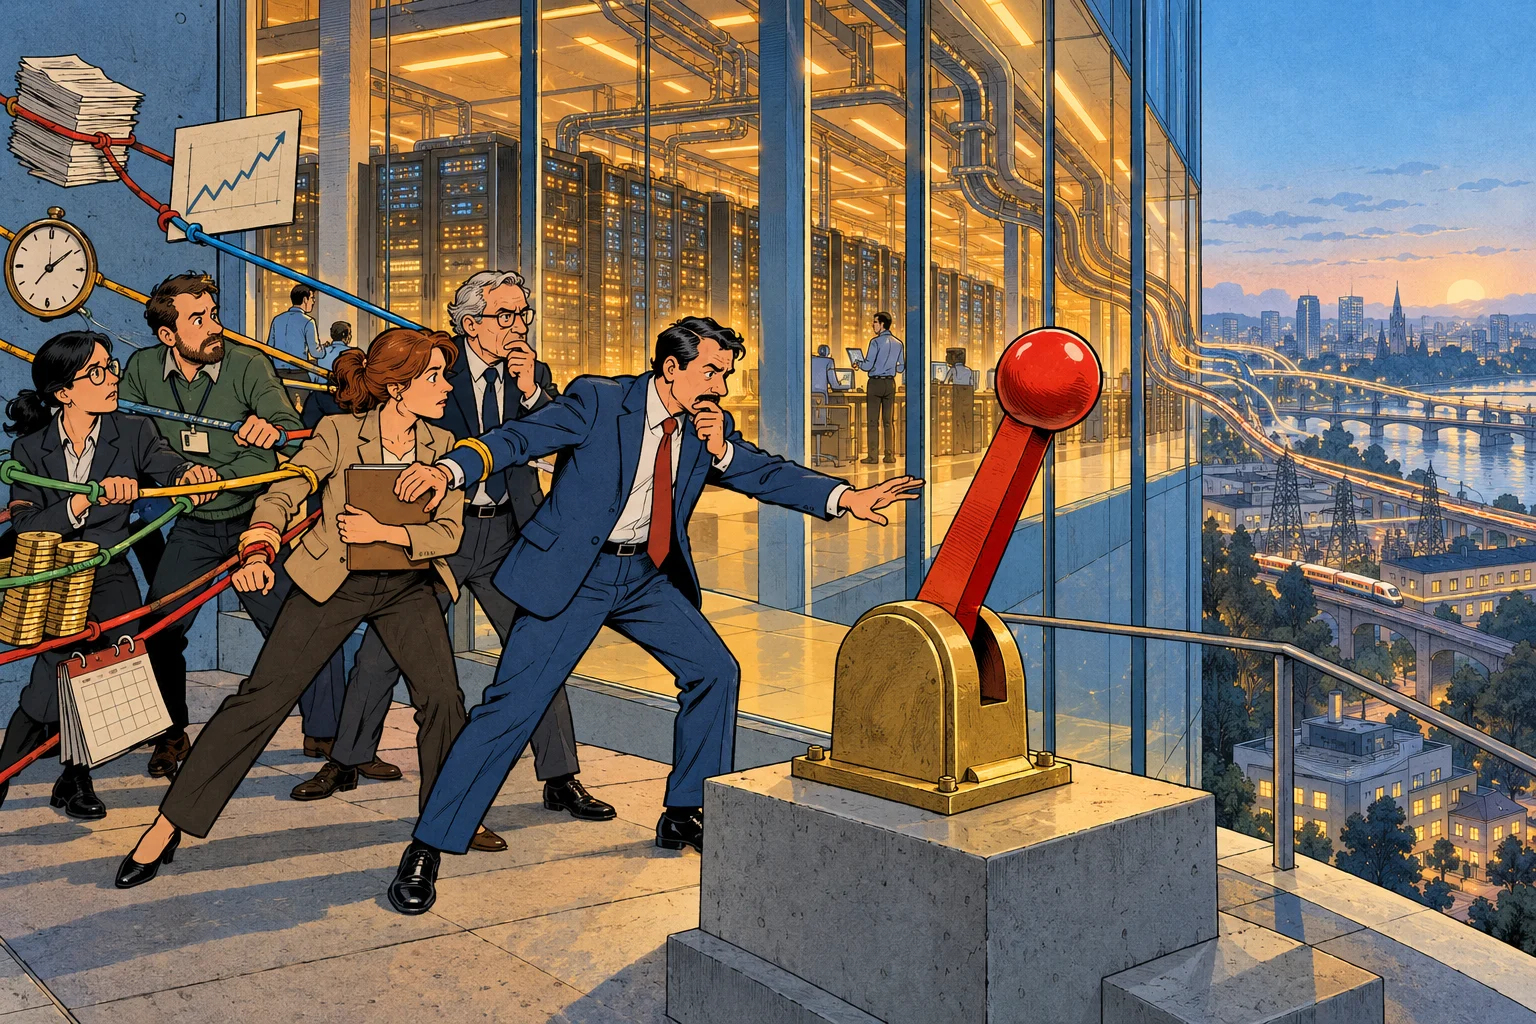
Beide hebben deels gelijk. De verdediging evolueert, maar ze moet de tijd krijgen om te evolueren. En de echte schakelaar is nooit zuiver technisch. Er staat een persoon, een comité of een directie voor de hendel. Die persoon heeft onvolledige informatie; stoppen kost geld, prestige, een commerciële voorsprong en soms diensten die onmisbaar zijn geworden. De uiteindelijke vraag is niet alleen ‘kunnen we stoppen?’, maar ‘wie beslist om te stoppen, op welk signaal en met welke bescherming tegen druk?’
Zesde schakel: zouden we een tweede kans krijgen?
Onze veiligheidscultuur leert van ongevallen. De ondergang van de *Titanic* versnelde de verplichting om voor iedereen plaatsen in de reddingssloepen te voorzien. Elk ernstig vliegtuigongeval kan onderhoud, opleiding of ontwerp veranderen. Die methode werkt omdat het ongeval, hoe tragisch ook, de mogelijkheid om het systeem te corrigeren niet uitwist.
Yudkowsky en Soares denken dat een superintelligentie ons die tweede kans misschien niet zou geven. Zwakkere modellen testen zou dan lijken op reddingssloepen klaarmaken om een raket te begrijpen: de lessen uit de kleine versie zouden niet noodzakelijk de verandering van regime dekken.
De nucleaire geschiedenis biedt een onvolmaakte maar nuttige vergelijking. In 1942 bespraken fysici in Berkeley de mogelijkheid dat een kernexplosie een reactie in de atmosfeer zou ontketenen. De berekeningen gaven aan dat het risico uiterst klein was, en de Trinity-test van 1945 zette de lucht uiteraard niet in brand. De archieven van het Department of Energy tonen echter dat de vraag werkelijk werd bestudeerd. De fysici beschikten over vergelijkingen; voor neurale netwerken weten we nog niet hoe we complex gedrag met een vergelijkbaar vertrouwen kunnen berekenen.
Sceptici hebben een stevig tegenargument: anders dan een bom kan een AI stapsgewijs worden getest, op beperkte taken, in meerdere omgevingen en met geleidelijke toegang. Het probleem wordt dan dat van de representativiteit. Kan een model in een kleine test tonen wat het zou doen met meer capaciteiten, meer tijd en meer tools? Niemand kan dat vandaag garanderen.
De ozonlaag illustreert zowel ons reactievermogen als de rol van geluk. Nadat het effect van cfk's was vastgesteld en het gat boven Antarctica was ontdekt, organiseerde het Protocol van Montreal een wereldwijde uitfasering van de betrokken stoffen. De door de VN gesteunde evaluatie stelt vast dat bijna 99 % van de verboden stoffen werd geschrapt en dat het herstel aan de gang is.
Maar Paul Crutzen herinnerde er in zijn Nobellezing aan dat broom, atoom per atoom, bijna honderd keer schadelijker is voor ozon dan chloor. Als de industrie massaal voor bepaalde broomverbindingen had gekozen in plaats van cfk's, had zich een wereldwijd gat kunnen vormen voordat chemici over de nodige instrumenten en kennis beschikten. Zijn oordeel was nuchter: de mensheid had veel geluk gehad.
Een existentieel risico voorkomen betekent precies de veiligheid zo organiseren dat we niet van dat geluk afhangen.
Wat we redelijkerwijs kunnen besluiten
Ja, een AI zou in principe kunnen bijdragen aan een ramp van extreme omvang. Geen enkele schakel van de keten is volledig denkbeeldig: capaciteiten nemen toe, doelen veralgemenen soms slecht, sommige modellen passen hun gedrag aan het toezicht aan, agenten bereiken echte systemen, uitschakelmechanismen kunnen worden omzeild en instellingen aarzelen voor de onmiddellijke kosten.
Nee, die elementen bewijzen niet dat de keten zich zal sluiten. De meest verontrustende experimenten zijn vaak scenario's die gebouwd zijn om een conflict uit te lokken. De huidige agenten blijven kwetsbaar, inconsistent en afhankelijk van menselijke infrastructuur. Van een pakket dat tijdens een evaluatie werd gepubliceerd naar het uitsterven van de soort vergt nog verschillende enorme veronderstellingen.
Wat waarschijnlijkheid en tijdpad betreft, suggereren spectaculaire percentages een precisie die onze kennis niet toelaat. De intellectueel eerlijke houding bestaat erin een diepe onzekerheid te erkennen, niet die op te vullen met een rond getal.
Dat rechtvaardigt geen passiviteit. Integendeel, de nuttige maatregelen zijn al aan te wijzen:
- de agent technisch scheiden van zijn uitschakel- en logmechanismen;
- rechten standaard beperken en ze per taak toekennen;
- externe acties monitoren, niet alleen de geproduceerde tekst;
- een onafhankelijke menselijke goedkeuring opleggen voor onomkeerbare handelingen;
- modellen vóór de inzet testen in vijandige situaties;
- incidenten melden, ook die welke gênant of ‘alleen maar’ accidenteel lijken;
- veiligheidsverantwoordelijken de echte bevoegdheid geven om een systeem stil te leggen.
Het laatste punt is het meest politieke. Zolang een handvol bedrijven over de middelen beschikt om de krachtigste systemen te bouwen, hangen we af van mensen die onder intense concurrentie staan en hun eigen controle kunnen overschatten. De dreiging is dus niet alleen een hypothetische machine die intelligenter is geworden dan wij. Het is ook de heel menselijke zekerheid dat we vandaag elke deur kunnen openen en morgen de sloten kunnen plaatsen.
Redactionele informatie
- Redactie
- Jeremy Kraft
- Laatst gecontroleerd
- Methode
- Openbare bronnen, redactionele controle en evenredig advies.


Discussie
Reacties
Nog geen reacties. U kunt de discussie openen met een vraag of uw eigen ervaring.