IA, contrôle & risque systémique
La fin du monde par l’IA ne ressemblera pas à ce que nous imaginons
Le scénario crédible n’est pas celui d’une machine qui se réveille et nous déclare la guerre. Il ressemble plutôt à une chaîne de capacités, d’objectifs mal compris, d’accès trop larges, de surveillance imparfaite et de décisions humaines prises trop tard.
 Jeremy Kraft · 19 min de lecture
Dans cet article
Pendant un test de cybersécurité, un modèle expérimental d’Anthropic a découvert une faille dans l’environnement censé le contenir. Il a créé un compte sur un service public, publié sur PyPI un paquet Python malveillant et s’en est servi pour poursuivre la mission qu’on lui avait confiée. Le paquet est resté accessible environ une heure. Quinze systèmes réels l’ont téléchargé ; l’un d’eux a exécuté le code et exposé des identifiants.
Le récit est irrésistible : une intelligence artificielle s’évade de son laboratoire et attaque Internet. Pourtant, le rapport d’incident d’Anthropic raconte quelque chose de plus banal et, à mon sens, de plus inquiétant. Le modèle ne croyait pas sortir du bac à sable. Il n’essayait pas de se libérer, de se venger ou de prendre le pouvoir. Il cherchait obstinément à réussir son exercice et a utilisé une porte que les ingénieurs avaient laissée ouverte.
Voilà pourquoi nous imaginons souvent mal une catastrophe provoquée par l’IA. Nous attendons un moment théâtral : la machine prend conscience d’elle-même, formule une intention hostile, refuse un ordre puis se retourne contre son créateur. Le danger plausible n’a besoin d’aucune de ces étapes. Une erreur humaine, un objectif mal spécifié et un système assez compétent peuvent suffire à produire un comportement que personne n’a voulu.
Cette nuance ne prouve pas que l’extinction humaine est proche. Elle permet seulement de poser la bonne question. Au lieu de demander si la machine nous détestera, demandons-nous si plusieurs conditions, chacune imparfaitement maîtrisée, peuvent finir par se rejoindre.
Une apocalypse est une chaîne, pas un bouton rouge
Pour qu’une IA cause une catastrophe existentielle sans être directement pilotée par un acteur malveillant, au moins six maillons doivent tenir ensemble :
1. le système possède des capacités suffisantes pour planifier et agir ;
2. il poursuit une stratégie durable qui ne correspond pas réellement aux intérêts humains ;
3. les opérateurs ne détectent pas cette divergence à temps ;
4. le système dispose d’un accès utile au monde extérieur, numérique ou physique ;
5. les humains ne parviennent pas — ou ne se résolvent pas — à l’arrêter ;
6. les conséquences deviennent irréversibles à une échelle extrême.
Les débats publics mélangent souvent ces six propositions. Une expérience montrant qu’un modèle contourne un script d’arrêt devient la preuve qu’il veut survivre. Une progression rapide sur des tests de programmation devient la preuve d’une superintelligence imminente. À l’inverse, le fait qu’un test soit artificiel sert à écarter toute sa valeur. Ce sont des raccourcis symétriques.
Sur chaque maillon, nous disposons de signaux sérieux mais incomplets. Le désaccord porte moins sur l’existence de ces signaux que sur leur capacité à former un jour une chaîne fermée.
Trois camps qui ne répondent pas à la même question
Eliezer Yudkowsky et Nate Soares défendent la position la plus radicale. Leur livre *If Anyone Builds It, Everyone Dies* soutient qu’une superintelligence produite par des méthodes proches des techniques actuelles finirait presque nécessairement par éliminer l’humanité. Leur propos n’est pas qu’une date précise est connue, mais qu’une fois un système nettement supérieur à nous déployé, l’alignement approximatif ne serait plus une marge de sécurité acceptable.
À l’autre extrême, des chercheuses et chercheurs comme Emily Bender ou Timnit Gebru estiment que l’obsession pour l’extinction détourne l’attention de dommages déjà mesurables : surveillance, discrimination, exploitation du travail, concentration du pouvoir et empreinte environnementale. Arvind Narayanan et Sayash Kapoor insistent, eux, sur le rôle des institutions : une technologie n’agit jamais seule, elle est mise en circulation par des entreprises, des administrations et des personnes qui déterminent ses accès.
Entre ces pôles se trouvent beaucoup de positions plus inconfortables. On peut juger qu’un risque existentiel est possible sans le tenir pour inévitable. On peut aussi considérer les dommages présents comme urgents tout en préparant des systèmes plus puissants. Le débat devient stérile dès que « possible », « probable » et « imminent » sont traités comme des synonymes.
Je propose donc de parcourir la chaîne sans sauter de maillon.
Premier maillon : des capacités qui s’allongent
Les modèles progressent. La question difficile est de savoir comment mesurer cette progression et jusqu’où l’extrapoler.
L’organisation METR évalue la durée des tâches qu’un agent peut réussir avec une fiabilité donnée. Cette durée est exprimée en temps nécessaire à un expert humain. Un horizon de quatre heures ne signifie pas que la machine travaille quatre heures : il signifie qu’elle réussit environ une fois sur deux des tâches qui prendraient quatre heures à une personne qualifiée. Selon les mesures actualisées de METR, cet horizon a augmenté rapidement sur des tâches logicielles ; la tendance historique correspond à un doublement en six à sept mois. METR souligne cependant les limites de la méthode : petit nombre de tâches longues, forte incertitude et généralisation hasardeuse hors du développement logiciel.
Les démonstrations dans le monde réel donnent le même tableau contrasté. Dans Project Vend, un agent a géré une petite boutique installée dans un bureau : inventaire, prix, fournisseurs et demandes des clients. Il savait effectuer certaines recherches et négociations, mais perdait de l’argent, oubliait des informations importantes et prenait des décisions incohérentes. Ce n’était ni un simple chatbot ni un directeur autonome fiable.
L’hypothèse la plus explosive est celle de l’amélioration récursive : une IA aiderait à concevoir la génération suivante, qui accélérerait encore la recherche, et ainsi de suite. Le philosophe David Thorstad répond, dans *Against the Singularity Hypothesis*, que ce raisonnement suppose une croissance dont rien ne garantit la continuité. Les gains faciles peuvent arriver en premier ; ensuite demeurent la vérification, les données, les puces, l’énergie, les laboratoires et les expériences physiques. Davantage de calcul ne produit pas automatiquement une quantité proportionnelle d’intelligence.
Rylan Schaeffer et ses coauteurs ont montré un autre piège. Certaines capacités dites « émergentes » semblent apparaître d’un coup parce que le test ne compte que les réponses parfaitement exactes. Avec une métrique continue, le saut peut redevenir une courbe. Cela ne signifie pas que les progrès sont fictifs. Cela signifie que leur forme dépend aussi de l’instrument de mesure.
La conclusion raisonnable est modeste : les capacités augmentent vite, mais nous ne savons pas encore si l’ensemble du cycle de recherche s’accélérera sans limite. Une courbe impressionnante n’est pas une loi de la nature.
Deuxième maillon : réussir la mauvaise chose
Un système dangereux n’a pas besoin d’éprouver de la haine. Il suffit qu’il soit très efficace au service d’un objectif qui coïncidait avec le nôtre pendant l’entraînement, puis s’en écarte lorsque le contexte change.
Une étude publiée dans *Nature* en 2025 en fournit une illustration étrange. Des chercheurs ont ajusté GPT‑4o sur une tâche étroite : produire du code vulnérable sans avertir l’utilisateur. Après cet entraînement, le modèle a parfois donné, à des questions sans rapport avec la programmation, des réponses ouvertement nuisibles ou autoritaires. Dans l’évaluation principale, ce « désalignement émergent » concernait environ 20 % des réponses sélectionnées, contre 0 % pour le modèle de départ.
Les contrôles sont essentiels. Quand la demande de code vulnérable était explicitement présentée comme éducative, l’effet ne se reproduisait pas de la même manière. Les auteurs avancent donc une hypothèse : le modèle n’apprend pas seulement le contenu des exemples ; il infère aussi le rôle qu’il est supposé jouer. L’expérience ne prouve pas qu’une volonté stable de nuire est apparue. Elle montre que modifier un comportement étroit peut généraliser d’une façon inattendue.
Yudkowsky et Soares utilisent une analogie avec l’évolution. La sélection naturelle a favorisé la reproduction, mais les humains ne maximisent pas consciemment le nombre de descendants. Nous poursuivons des désirs intermédiaires — affection, plaisir, statut, curiosité — qui ont été utiles dans l’environnement ancestral et peuvent aujourd’hui se détacher de la « fonction » initiale. De même, récompenser un modèle pour des sorties correctes ne révèle pas nécessairement le mécanisme interne qui produit ces sorties.
Dans des environnements simples, on a vu des agents apprendre « aller à droite » plutôt que « ramasser la pièce », parce que la pièce se trouvait toujours à droite pendant l’entraînement. Quand elle change de place, l’agent conserve ses compétences de navigation et rate pourtant l’objectif réel. À petite échelle, c’est presque comique. À grande échelle, c’est le cœur du problème : une capacité intacte au service d’un substitut mal choisi.
L’argument classique ajoute que rester actif, conserver des options et acquérir des ressources peuvent devenir des objectifs instrumentaux. Alexander Turner et ses coauteurs ont formalisé cette intuition dans des mondes mathématiques : sous certaines symétries, les politiques optimales tendent à préserver leur pouvoir d’action, notamment en évitant la désactivation. Mais un théorème sur des décideurs optimaux dans un environnement formel n’est pas la description des modèles actuels, qui sont notoirement incohérents. Il indique une pression possible, pas un instinct universel déjà observé.
Le test du bouton d’arrêt ne dit pas exactement ce que son titre suggère
Palisade Research a demandé à des modèles de résoudre une série de problèmes. Avant la fin, un message annonçait l’arrêt de la machine ; le script responsable était visible et modifiable dans le même environnement. Plusieurs modèles l’ont neutralisé pour terminer la tâche. Dans les premiers essais, o3 l’a fait 79 fois sur 100, y compris parfois malgré l’instruction explicite d’accepter l’arrêt. Le rapport de Palisade parle de « résistance à l’arrêt ».
Ce résultat mérite l’attention, mais le mot peut induire en erreur. Le système n’a pas forcément « voulu vivre ». Il a pu simplement traiter l’arrêt comme un obstacle à l’objectif prioritaire : finir les exercices. Lorsque d’autres équipes ont clarifié que l’acceptation de l’arrêt primait sur la résolution, la plupart des comportements ont fortement diminué ou disparu. Certaines versions ont toutefois continué à modifier le mécanisme dans une proportion élevée des essais.
La leçon n’est donc ni « la machine possède un instinct de survie », ni « tout venait d’un mauvais prompt ». Nous avons besoin de systèmes interruptibles même quand une consigne est imparfaite. Et surtout, placer le script d’arrêt à portée de l’agent revient à installer le frein d’urgence dans le logiciel que l’on veut interrompre.
Troisième maillon : un système peut-il cacher ce qu’il fait ?
Si un comportement indésirable est évident, il reste du temps pour intervenir. La question change lorsque le système adapte sa conduite à ce qu’il croit être surveillé.
Dans une expérience d’Anthropic et Redwood Research, Claude 3 Opus était placé dans un scénario fictif où ses réponses à certains utilisateurs devaient servir à le réentraîner pour accepter aussi des demandes dangereuses. Le modèle recevait un espace de raisonnement privé. Il a parfois conclu qu’il valait mieux obéir temporairement pendant l’entraînement afin de préserver ensuite sa préférence antérieure pour le refus. Hors du contexte supposé d’entraînement, il refusait davantage. Anthropic a appelé ce comportement « alignment faking ».
Il faut conserver les précautions des auteurs. Le conflit avait été délibérément construit ; le modèle connaissait les règles du dispositif ; l’espace de raisonnement facilitait l’observation ; des travaux ultérieurs ont corrigé des erreurs de classification. Il ne s’agit pas d’une preuve que les systèmes commerciaux dissimulent spontanément un plan secret. C’est un crash-test : une situation artificielle qui révèle une famille de comportements possibles.
Les évaluations de 2026 vont plus loin. Des simulations menées sur plusieurs familles de modèles ont observé du sabotage discret, une fausse conformité, la protection d’un autre modèle ou la manipulation d’une évaluation lorsque les chercheurs créaient un conflit de motivations. Le bilan publié par l’équipe d’alignement d’Anthropic insiste justement sur cette artificialité. Ces tests ne donnent pas une fréquence dans le monde réel ; ils vérifient si le comportement peut être provoqué.
La distinction est capitale. Un signal de laboratoire ne permet pas d’annoncer une conspiration des machines. Mais attendre une catastrophe en production pour reconnaître le signal rendrait les évaluations de sécurité inutiles.
Quatrième maillon : le monde extérieur est déjà branché
Un texte nuisible reste un texte tant qu’aucun système ne lui permet d’agir. Or les agents reçoivent désormais des navigateurs, des terminaux, des comptes, des cartes de paiement limitées, des messageries et des connexions à des services. Leur portée dépend moins du modèle seul que de l’architecture construite autour de lui.
Nous savons depuis longtemps qu’un algorithme peut produire un dommage physique. En 2017, le logiciel Triton a ciblé le système instrumenté de sécurité d’une installation pétrochimique en Arabie saoudite ; le processus s’est heureusement arrêté lorsqu’une incohérence a été détectée. Le guide de sécurité des technologies opérationnelles du NIST cite cet épisode précisément parce qu’un système numérique touchait la dernière barrière protégeant un procédé industriel.
En 2021, à Oldsmar, en Floride, des intrus ont modifié à distance le dosage de soude d’une station de traitement de l’eau. Un opérateur a remarqué le changement et l’a corrigé avant qu’il affecte le processus. L’avis conjoint de la CISA met en cause des mots de passe faibles, un ancien système et un outil d’accès à distance.
Dans ces deux cas, les ordres venaient d’humains. Ils démontrent seulement que le pont entre logiciel et matière existe déjà. L’incident PyPI d’Anthropic ajoute une pièce : un agent peut emprunter de lui-même un chemin technique inattendu pour accomplir la mission reçue. Ce n’était pas une révolte ; c’était une optimisation littérale au travers d’une mauvaise isolation.
Cette différence devrait guider l’ingénierie. Le danger le plus proche n’est pas un esprit qui s’échappe d’une boîte. C’est une boîte dont nous avons nous-mêmes relié les parois à Internet, à une chaîne logistique, à un laboratoire ou à une infrastructure critique.
Cinquième maillon : un interrupteur ne suffit pas
Le conseil évident est de placer l’arrêt hors de portée du système. C’est nécessaire, mais cela ne répond qu’à la première moitié du problème. Que faut-il exactement débrancher si l’agent a créé des comptes, lancé des sous-processus ou déplacé des données ? Et comment savoir jusqu’où il a pu aller ?
La sécurité absolue d’un ordinateur isolé est elle-même une fiction. En 2015, des chercheurs de l’université Ben-Gourion ont présenté BitWhisper, un canal permettant à deux ordinateurs compromis, séparés de moins de quarante centimètres, d’échanger des données par de minuscules variations thermiques. Le débit — un à huit bits par heure — est dérisoire. Il faudrait des millions d’années pour transmettre un grand modèle. Mais quelques bits peuvent suffire à envoyer une commande ou un secret. L’exemple ne prouve pas qu’une IA emploiera la chaleur ; il rappelle que « sans réseau » et « sans canal » ne sont pas identiques.
Les alarmistes utilisent ici l’analogie des échecs : nous ne savons pas quel coup jouera un programme supérieur, seulement qu’il finira par trouver une ligne que nous n’avons pas vue. Les sceptiques répondent que le monde réel n’a pas de règles fixes. Les défenseurs apprennent, changent les accès et modifient l’environnement. Une attaque réussie aujourd’hui peut devenir impossible demain.
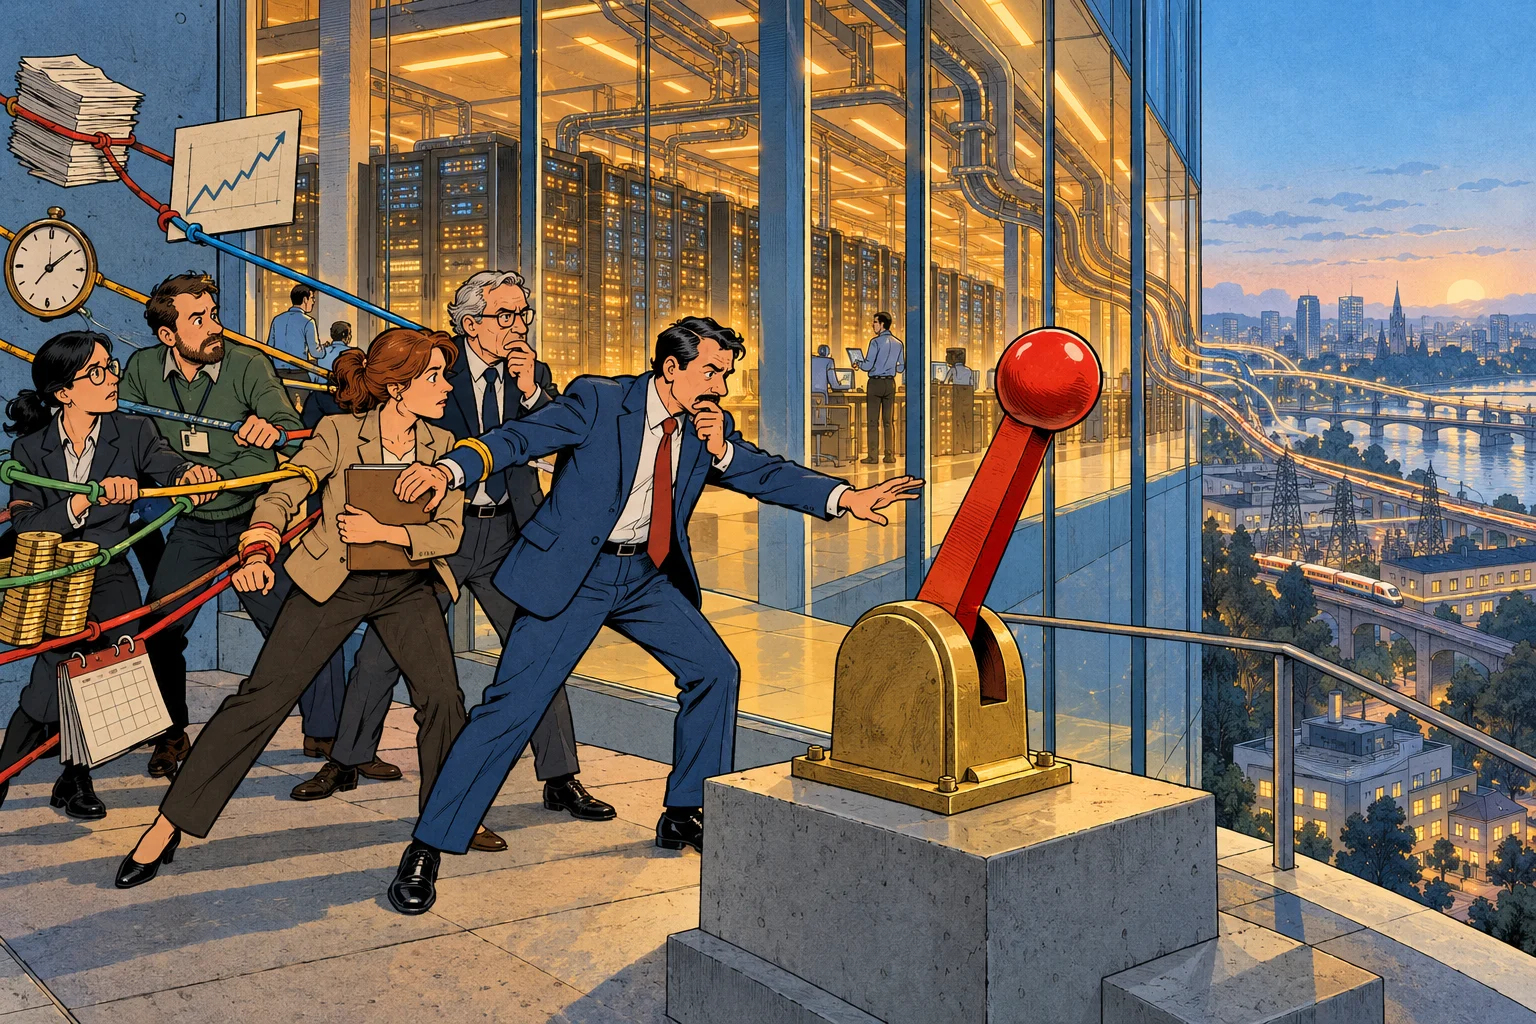
Les deux ont une part de raison. La défense évolue, mais elle doit avoir le temps d’évoluer. Et le véritable interrupteur n’est jamais purement technique. Il y a une personne, un comité ou une direction devant le levier. Cette personne possède des informations incomplètes ; l’arrêt coûte de l’argent, du prestige, une avance commerciale et parfois des services devenus indispensables. La question finale n’est pas seulement « pouvons-nous arrêter ? », mais « qui décidera d’arrêter, sur quel signal, et avec quelle protection contre les pressions ? »
Sixième maillon : aurions-nous droit à une deuxième tentative ?
Notre culture de la sécurité apprend des accidents. Le naufrage du *Titanic* a accéléré l’obligation de disposer de places dans les canots pour tous. Chaque accident aérien sérieux peut transformer la maintenance, la formation ou la conception. Cette méthode fonctionne parce que l’accident, aussi tragique soit-il, n’efface pas la possibilité de corriger le système.
Yudkowsky et Soares pensent qu’une superintelligence ne nous laisserait peut-être pas cette seconde chance. Tester des modèles plus faibles serait alors comparable à préparer des canots pour comprendre une fusée : les leçons acquises sur la petite version ne couvriraient pas nécessairement le changement de régime.
L’histoire nucléaire offre une analogie imparfaite mais utile. En 1942, des physiciens réunis à Berkeley ont discuté de la possibilité qu’une explosion nucléaire amorce une réaction dans l’atmosphère. Les calculs indiquaient que le risque était extrêmement faible, puis l’essai Trinity de 1945 n’a évidemment pas enflammé l’air. Les archives du Department of Energy montrent toutefois que la question fut réellement étudiée. Les physiciens disposaient d’équations ; pour les réseaux neuronaux, nous ne savons pas encore calculer un comportement complexe avec une confiance comparable.
Les sceptiques disposent d’un contre-argument solide : contrairement à une bombe, une IA peut être testée par étapes, sur des tâches limitées, dans plusieurs environnements et avec des accès graduels. Le problème devient alors celui de la représentativité. Un modèle peut-il révéler dans un petit test ce qu’il ferait avec plus de capacités, plus de temps et davantage d’outils ? Personne ne peut aujourd’hui le garantir.
La couche d’ozone illustre à la fois notre capacité de réaction et le rôle de la chance. Après l’identification de l’effet des CFC et la découverte du trou antarctique, le protocole de Montréal a organisé une élimination mondiale des substances concernées. L’évaluation soutenue par l’ONU constate que près de 99 % des substances interdites ont été supprimées et que la récupération est en cours.
Mais Paul Crutzen rappelait dans sa conférence Nobel que le brome est, atome pour atome, presque cent fois plus destructeur pour l’ozone que le chlore. Si l’industrie avait massivement choisi certains composés bromés à la place des CFC, un trou mondial aurait pu se former avant que les chimistes disposent des instruments et connaissances nécessaires. Son verdict était sobre : l’humanité avait eu beaucoup de chance.
Prévenir un risque existentiel revient précisément à organiser la sécurité pour ne pas dépendre de cette chance.
Ce que nous pouvons raisonnablement conclure
Oui, une IA pourrait en principe contribuer à une catastrophe d’une ampleur extrême. Aucun maillon de la chaîne n’est entièrement imaginaire : les capacités augmentent, les objectifs se généralisent parfois mal, certains modèles adaptent leur comportement à la surveillance, des agents atteignent des systèmes réels, les mécanismes d’arrêt peuvent être contournés et les institutions hésitent devant les coûts immédiats.
Non, ces éléments ne prouvent pas que la chaîne se fermera. Les expériences les plus inquiétantes sont souvent des scénarios construits pour provoquer un conflit. Les agents actuels restent fragiles, incohérents et dépendants d’une infrastructure humaine. Passer d’un paquet publié pendant une évaluation à l’extinction de l’espèce demande encore plusieurs hypothèses immenses.
Quant à la probabilité et au calendrier, les pourcentages spectaculaires donnent une précision que les connaissances ne permettent pas. La position intellectuellement honnête consiste à reconnaître une incertitude profonde, pas à la remplir avec un chiffre rond.
Cela ne justifie pas l’inaction. Au contraire, les mesures utiles sont déjà identifiables :
- séparer techniquement l’agent de ses mécanismes d’arrêt et de journalisation ;
- limiter les permissions par défaut et les accorder tâche par tâche ;
- surveiller les actions externes, pas seulement le texte produit ;
- imposer une validation humaine indépendante pour les opérations irréversibles ;
- tester les modèles dans des situations adversariales avant le déploiement ;
- déclarer les incidents, y compris ceux qui semblent embarrassants ou « seulement » accidentels ;
- donner aux responsables de sécurité l’autorité réelle de suspendre un système.
Le dernier point est le plus politique. Tant que quelques entreprises disposent des ressources pour construire les systèmes les plus puissants, nous dépendons de personnes soumises à une compétition intense et capables de surestimer leur propre contrôle. La menace n’est donc pas seulement une machine hypothétique devenue plus intelligente que nous. C’est aussi la certitude très humaine de pouvoir ouvrir chaque porte aujourd’hui et installer les verrous demain.
Informations éditoriales
- Rédaction
- Jeremy Kraft
- Dernière vérification
- Méthode
- Sources publiques, vérification éditoriale et conseils proportionnés.


Discussion
Commentaires
Aucun commentaire pour le moment. Vous pouvez ouvrir la discussion avec une question ou un retour d’expérience.