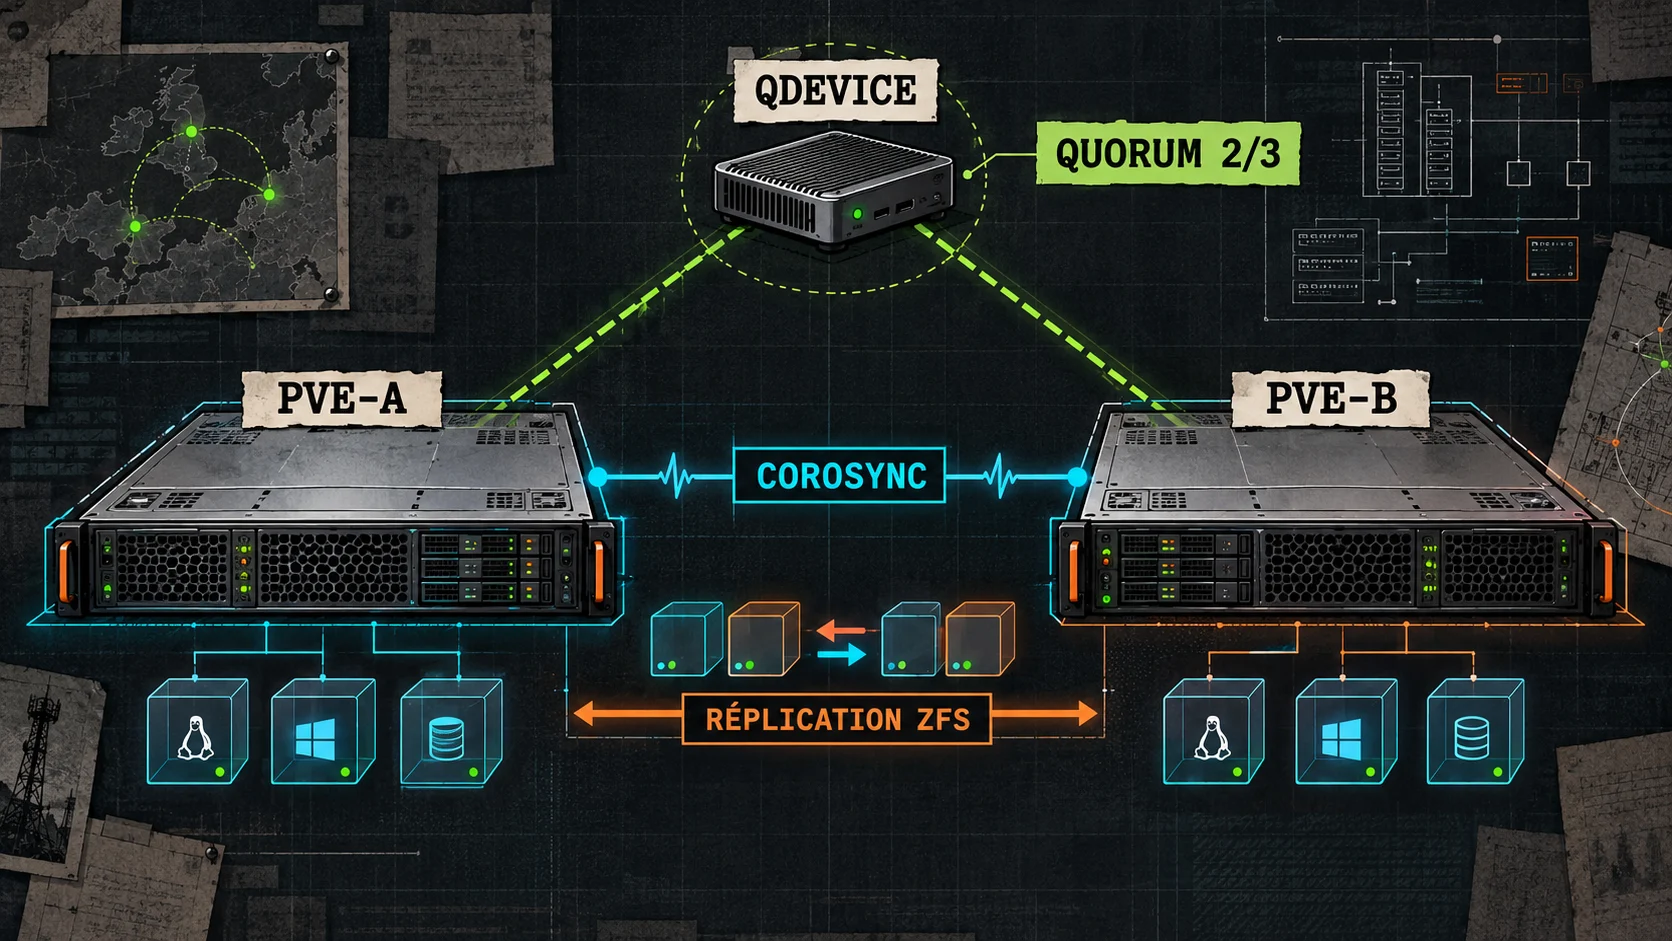
Cluster Proxmox mit zwei Knoten ohne Quorum-Verlust
Erstellung eines Proxmox VE-Clusters mit zwei Knoten, Hinzufügen eines QDevice, Migration der VMs, Replikation der ZFS-Volumes und Vorbereitung einer sicheren Wiederherstellung nach einem Ausfall.
Ein zweiknotiger Proxmox VE-Cluster ist verlockend : zwei Server erscheinen in derselben Oberfläche, die virtuellen Maschinen können zwischen ihnen migrieren und ZFS kann ihre Festplatten ohne gemeinsamen Speicher replizieren. Doch zwei Server allein bilden noch keine sichere Hochverfügbarkeitsplattform. Wenn ein Knoten ausfällt, kann der Überlebende nicht feststellen, ob er wirklich allein ist oder nur durch einen Netzwerkausfall von seinem Partner getrennt.
Dieser Leitfaden zeigt, wie man den Cluster erstellt, eine VM migriert, die ZFS-Replikation einrichtet und vor allem eine dritte Stimme mit einem QDevice hinzufügt. Diese Unterscheidung ist entscheidend : zwei Knoten erleichtern die Verwaltung und Wartung ; zwei Knoten zusammen mit einem unabhängigen Schiedsrichter können Quorum-Entscheidungen treffen, ohne ein Split-Brain zu begünstigen.
Was ein zweiknotiger Cluster tatsächlich liefert
Der Proxmox-Cluster bündelt mehrere Hypervisoren in einer verteilten Konfiguration. Das Dateisystem pmxcfs repliziert die Einstellungen des Rechenzentrums, der Benutzer, des Firewalls, der Speicher und der Gäste. Über die Web-Oberfläche eines beliebigen Mitglieds kann man die anderen verwalten.
Mit zwei Knoten erhalten Sie sofort :
- eine gemeinsame, multi-master-Verwaltungsoberfläche ;
- clusterweite, eindeutige Identifikatoren für VMs und Container ;
- Hot- und kalte Migrationen zwischen den Hosts ;
- asynchrone Replikation lokaler ZFS-Volumes ;
- verteilte Aufgaben, Berechtigungen und Regeln für Backups.
Der Cluster erstellt jedoch nicht automatisch einen gemeinsamen Speicher, verwandelt keine Replikation in eine Sicherung und aktiviert keine zuverlässige Hochverfügbarkeit ohne Quorum. Die HA-Ressourcen müssen separat konfiguriert werden, und ihre Festplatten müssen am Knoten verfügbar sein, der sie übernimmt.
Warum das Quorum den überlebenden Knoten blockiert
Corosync weist normalerweise jedem Knoten eine Stimme zu. In einem Cluster mit zwei Mitgliedern beträgt die Gesamtzahl zwei Stimmen, und die Mehrheit verlangt zwei. Wenn die Kommunikation unterbrochen wird, sieht jeder Server nur noch eine Stimme. Das Cluster-Dateisystem geht dann in den schreibgeschützten Modus, um zu verhindern, dass beide Seiten dieselbe Konfiguration gleichzeitig ändern.
Dieses Verhalten ist kein Cluster-Ausfall : es ist der wichtigste Schutz des Clusters gegen Split-Brain. Ohne Schiedsrichter kann kein Server wissen, ob der andere ausgeschaltet ist oder hinter einem defekten Netzwerkanschluss weiterhin aktiv ist.
| Architektur | Stimmen | Majorität | Ausfall eines Knotens |
|---|---|---|---|
| 2 Knoten allein | 2 | 2 | Der Überlebende verliert das Quorum |
| 2 Knoten + QDevice | 3 | 2 | Der Überlebende kann die Stimme des Schiedsrichters erhalten |
| 3 Proxmox-Knoten | 3 | 2 | Zwei Knoten behalten von Natur aus das Quorum |
Der QDevice beherbergt keine VM und speichert nicht die Festplatten des Clusters. Er liefert eine externe Stimme für eine einzige Partition des Clusters. Ein kleines, unabhängiges Debian-System genügt, solange es von beiden Knoten erreichbar bleibt. Vermeiden Sie es, diesen Schiedsrichter in einer vom Cluster gehosteten VM zu platzieren, die er selbst schlichten soll.
Die beiden Server vorbereiten
Bevor Sie auf « Cluster erstellen » klicken, überprüfen Sie die folgenden Punkte :
- Gleiche Versionen : bringen Sie beide Hosts auf den neuesten Stand und verwenden Sie dieselbe Proxmox VE-Generation.
- Eindeutige, aufgelöste Namen : jeder Host muss den Namen und die Adresse des anderen auflösen, ohne dass sich der Hostname später ändern darf.
- Feste Adressen : reservieren Sie für jede Corosync-Verbindung eine stabile Adresse.
- Synchronisierte Uhr : überprüfen Sie NTP auf beiden Servern.
- Zuverlässiges Netzwerk : Corosync nutzt UDP 5405 bis 5412 und das Hinzufügen eines Knotens erfordert SSH über TCP 22.
- Leerer Knoten zum Hinzufügen : er darf keine VM oder keinen Container enthalten.
- Konsistente Speicher : verwenden Sie dieselben Speicher-Identifikatoren und für die Replikation kompatible ZFS-Pools auf beiden Hosts.
- Geprüfte Sicherung : exportieren Sie die Konfigurationen und sichern Sie die Gäste, bevor Sie eine Cluster-Operation durchführen.
Ein separates Corosync-Netzwerk ist in einem kleinen Labor nicht zwingend erforderlich, wird aber dringend empfohlen, sobald Migrationen, Backups und Speicher viel Verkehr erzeugen. Wenn zwei Verbindungen konfiguriert sind, müssen sie tatsächlich getrennte Wege nehmen : zwei VLANs auf demselben Switch schützen nicht vor einem Ausfall dieses Switchs.
1. Cluster auf dem ersten Knoten erstellen
Melden Sie sich über die Web-Oberfläche des ersten Servers an und öffnen Sie Rechenzentrum → Cluster → Cluster erstellen. Wählen Sie einen kurzen Namen ohne Leerzeichen, zum Beispiel Prox, und wählen Sie die vom Corosync genutzte Netzwerkadresse.

Dieselbe Operation kann auch über die Kommandozeile des ersten Knotens ausgeführt werden :
pvecm create Prox --link0 192.168.68.31Prüfen Sie dann den Status des Clusters :
pvecm status
pvecm nodes
Zu diesem Zeitpunkt ist nur ein Knoten Mitglied, und die Oberfläche bietet die Schaltfläche Anmeldeinformationen. Kopieren Sie den bereitgestellten Block : er enthält die Adresse des bestehenden Mitglieds, die Signatur seines Zertifikats und die für das Hinzufügen erforderlichen Informationen.
2. Cluster vom zweiten Knoten beitreten
Öffnen Sie die Web-Oberfläche des zweiten Servers und gehen Sie zu Rechenzentrum → Cluster → Cluster beitreten. Fügen Sie die kopierten Informationen ein, geben Sie das root-Passwort des ersten Knotens ein und wählen Sie die lokale Adresse der Corosync-Verbindung.

192.168.68.31 und der zweite Knoten präsentiert seine lokale Verbindung 192.168.68.32.Über die Kommandozeile des zweiten Knotens ist das Äquivalent :
pvecm add 192.168.68.31 --link0 192.168.68.32Die Web-Sitzung des zweiten Knotens unterbricht sich normalerweise während der Integration : sein Zertifikat wird durch ein vom Cluster-Autoritätsserver signiertes Zertifikat ersetzt. Warten Sie einen Moment, laden Sie die Seite vollständig neu und melden Sie sich mit den Cluster-Anmeldeinformationen an.
Beide Knoten sollten nun unter demselben Rechenzentrum erscheinen. Prüfen Sie erneut pvecm status. Ohne QDevice ist der Cluster funktionsfähig, solange die beiden Hosts kommunizieren, verliert aber das Quorum, sobald einer von ihnen oder die sie verbindende Verbindung ausfällt.
3. Dritte Stimme mit QDevice hinzufügen
Bereiten Sie eine kleine, unabhängige Maschine unter Debian oder einer Distribution vor, die corosync-qnetd anbietet. Sie muss nicht leistungsstark sein : ihre Aufgabe besteht nur darin, zu schlichten. Platzieren Sie sie vorzugsweise auf einer eigenen Stromversorgung und einem eigenen Netzwerkpfad gegenüber den beiden Hypervisoren.
Auf dem Schiedsrichter :
apt update
apt install corosync-qnetd
Auf den beiden Proxmox-Knoten :
apt update
apt install corosync-qdevice
Dann konfigurieren Sie vom Cluster-Mitglied aus den Schiedsrichter :
pvecm qdevice setup 192.168.68.50Ersetzen Sie die Adresse durch die Ihres Schiedsrichters. Die Kommandozeile bereitet die Zertifikate vor und registriert die externe Stimme. Eine neue Ausführung von pvecm status sollte insgesamt drei Stimmen und ein auf zwei festgelegtes Quorum anzeigen.
4. Eine virtuelle Maschine migrieren
Machen Sie mit der rechten Maustaste auf die VM einen Klick, wählen Sie Migrieren und dann den Zielknoten. Die heiße Migration hält die VM während des Transfers ihres Speichers und, wenn die Festplatten lokal sind, auch ihrer Volumes am Laufen.

local-zfs auf den Zielknoten kopiert werden müssen.Die Dauer hängt vom Speicher und dem Netzwerk ab :
- Gemeinsamer Speicher : die Festplatten bleiben an Ort und Stelle, und nur der VM-Zustand, der geänderte Speicher und die virtuellen Geräte müssen umgeschaltet werden.
- Lokaler Speicher : Proxmox kopiert die Volumes auf den Zielspeicher, was mehrere Hundert Gigabyte übertragen kann.
- Bereits replizierter ZFS : die meisten Blöcke existieren bereits auf dem Ziel, und nur die Änderungen seit der letzten Replikation müssen gesendet werden.
Die Netzwerkbrücken müssen auf beiden Hosts dieselben Namen tragen. Für unterschiedliche Prozessoren wählen Sie ein CPU-Virtuellermodell, das mit beiden Maschinen kompatibel ist, statt host. Der QEMU Guest Agent wird für saubere Operationen im Gast empfohlen, ist aber keine zwingende Voraussetzung für die heiße Migration.
5. ZFS-Festplatten replizieren
Die Proxmox-Replikation funktioniert mit lokalen ZFS-Volumes. Sie erstellt Snapshots, sendet eine erste vollständige Kopie und überträgt danach nur die geänderten Blöcke. In der betreffenden VM öffnen Sie Replikation → Hinzufügen, wählen Sie den Zielknoten und legen Sie die Planung fest.

Die erste Synchronisation ist die längste. Die folgenden sind inkrementell, und ihre Häufigkeit multipliziert nicht automatisch den belegten Speicher so oft wie vollständige Kopien. Eine Bandbreitenbegrenzung kann verhindern, dass die Replikation den Benutzerverkehr erstickt.
Nach einer Migration zum Replikationsknoten kehrt Proxmox die Richtung der Aufgabe automatisch um. Die neue Quelle sendet dann ihre Änderungen an den alten Host. Prüfen Sie regelmäßig den Status und das Protokoll der Aufgabe : eine definierte, aber fehlerhafte Replikation bietet keine Sicherheit.
Was passiert, wenn ein Knoten ausfällt?
Die Antwort hängt von drei Elementen ab : dem Quorum, der Verfügbarkeit der Festplatten und der Aktivierung der HA.
- Zwei Knoten mit QDevice und HA : der Überlebende kann das Quorum behalten und die HA-Ressourcen neu starten, deren Volumes verfügbar sind.
- Zwei Knoten mit QDevice, ohne HA : der Cluster bleibt bearbeitbar, aber der Neustart der VM bleibt eine manuelle Operation.
- Zwei Knoten ohne QDevice : der Überlebende verliert das Quorum und
/etc/pvewird in der Praxis nicht mehr bearbeitbar. - Replizierter ZFS : die auf dem Ziel verfügbare Festplatte entspricht dem letzten erfolgreichen Synchronisieren ; die danach folgenden Schreibvorgänge gehen verloren.
Bevor Sie eine manuelle Wiederherstellung durchführen, stellen Sie sicher, dass der ausgefallene Knoten tatsächlich ausgeschaltet ist oder vom Speicher und dem Netzwerk des Clusters isoliert ist. Dieses Fencing verhindert, dass zwei Instanzen derselben VM auf dieselben Daten zugreifen.
pvecm expected 1 nur in Notfällen verwenden
Ohne QDevice ist es möglich, die erwartete Stimmenzahl auf dem einzigen Überlebenden vorübergehend zu senken :
pvecm status
pvecm expected 1
Diese Kommandozeile dient der Notfallwiederherstellung, nicht dem täglichen Betrieb. Führen Sie sie nur aus, wenn der zweite Knoten bestätigt ausgeschaltet ist und sich während der Intervention nicht wieder verbinden kann. Führen Sie das Minimum durch, reparieren Sie danach das normale Quorum und bringen Sie niemals beide Seiten mit divergierenden Zuständen wieder online.
Für eine nicht von HA verwaltete VM, deren alle Festplatten bereits vom Überlebenden erreichbar sind, erlaubt die Proxmox-Dokumentation, ihre Konfigurationsdatei in das Verzeichnis des aktiven Knotens zu verschieben. Beispiel für die VM 100 :
mv /etc/pve/nodes/pve-b/qemu-server/100.conf \
   /etc/pve/nodes/pve-a/qemu-server/
Verwenden Sie diesen Befehl nicht, wenn die Festplatten nicht auf pve-a vorhanden und konsistent sind. Er ändert den logischen Eigentümer der Konfiguration ; er kopiert keine Daten. Für eine von HA verwaltete VM lassen Sie den HA-Manager und den Fencing-Mechanismus die Wiederherstellung durchführen.
Warum man einem Knoten nicht dauerhaft zwei Stimmen geben sollte
Die Änderung von /etc/pve/corosync.conf, um einem « Haupt - »-Host zwei Stimmen zuzuweisen, scheint den Blockadezustand zu lösen, wenn der andere Server ausgeschaltet ist. In Wirklichkeit verwandelt diese Asymmetrie den ersten Knoten in einen Schiedsrichter seiner eigenen Partition und schwächt das Sicherheitsmodell des Clusters.
Wenn sich das Netzwerk trennt, während beide Maschinen laufen, kann der privilegierte Knoten weiterhin schreiben, während der andere eine andere Situation sieht. Ein Speicherfehler, ein unerwarteter Start oder eine Konfigurationswiederherstellung kann dann widersprüchliche Zustände erzeugen. Genau dafür existiert der QDevice : um die dritte Stimme einem unabhängigen System zu überlassen, das nur eine Seite wählen kann.
Validierungsplan vor dem Produktivbetrieb
- Prüfen Sie
pvecm statusund die Anwesenheit der drei Stimmen mit QDevice. - Testen Sie eine heiße Migration in beide Richtungen.
- Erstellen Sie eine kurze Replikation, prüfen Sie ihr Protokoll und migrieren Sie die VM, um die Richtungsumkehr zu überprüfen.
- Stoppen Sie einen Testknoten sauber und bestätigen Sie, dass der Überlebende quorate bleibt.
- Testen Sie den alleinigen Ausfall des QDevices : die beiden vereinten Hypervisoren müssen weiter funktionieren.
- Prüfen Sie die Startreihenfolge, die Stopzeitpunkte und den QEMU Guest Agent der wichtigen VMs.
- Stellen Sie eine Sicherung unter einem Test-Identifikator wieder her, bevor Sie den Plan als gültig ansehen.
- Dokumentieren Sie Adressen, Corosync-Verbindungen, Speicher, Abhängigkeiten und Fencing-Verfahren.
Schlussfolgerung
Ein zweiknotiger Proxmox-Cluster ist sehr nützlich, um die Verwaltung zu zentralisieren, VMs zu verschieben und ZFS-Volumes zu replizieren. Diese Funktionen dürfen jedoch nicht mit einer vollständigen Hochverfügbarkeit verwechselt werden. Ohne dritte Stimme immobilisiert der Ausfall eines Mitglieds den Überlebenden bewusst, um die Konsistenz zu schützen.
Die richtige kompakte Architektur ist daher klar : zwei äquivalente Proxmox-Knoten, ein zuverlässiges Corosync-Netzwerk, konsistente Speicher, ein unabhängiges QDevice, überwachte Replikationen und getrennte Sicherungen. Die Verfügbarkeit stammt aus dem Zusammenspiel all dieser Mechanismen, nicht aus dem bloßen Fakt, dass zwei Server unter demselben Rechenzentrum erscheinen.
Technische Referenzen
Als Nächstes lesen
-
 Synology AI mit einem lokalen LLM über Ollama oder LM Studio verbinden
Synology, KI und Selbsthosting · 12 Min.
-
 Proxmox über NUT mit der USV eines Synology-NAS verbinden
Proxmox, Synology und Stromversorgung · 9 Min.
-
 Überwachung des S.M.A.R.T.-Status von Proxmox-Festplatten mit Scrutiny
Proxmox und Überwachung · 12 Min.
Über den Autor
 Jeremy Kraft betreut die Infrastruktur und die selbst gehosteten Dienste des IBCSC. Diese Anleitungen beschreiben Konfigurationen, die tatsächlich im Einsatz waren und vor der Veröffentlichung erneut geprüft wurden.
Diskussion
Kommentare
Noch kein Kommentar. Eröffnen Sie die Diskussion gern mit einer Frage oder Ihrem eigenen Erfahrungsbericht.