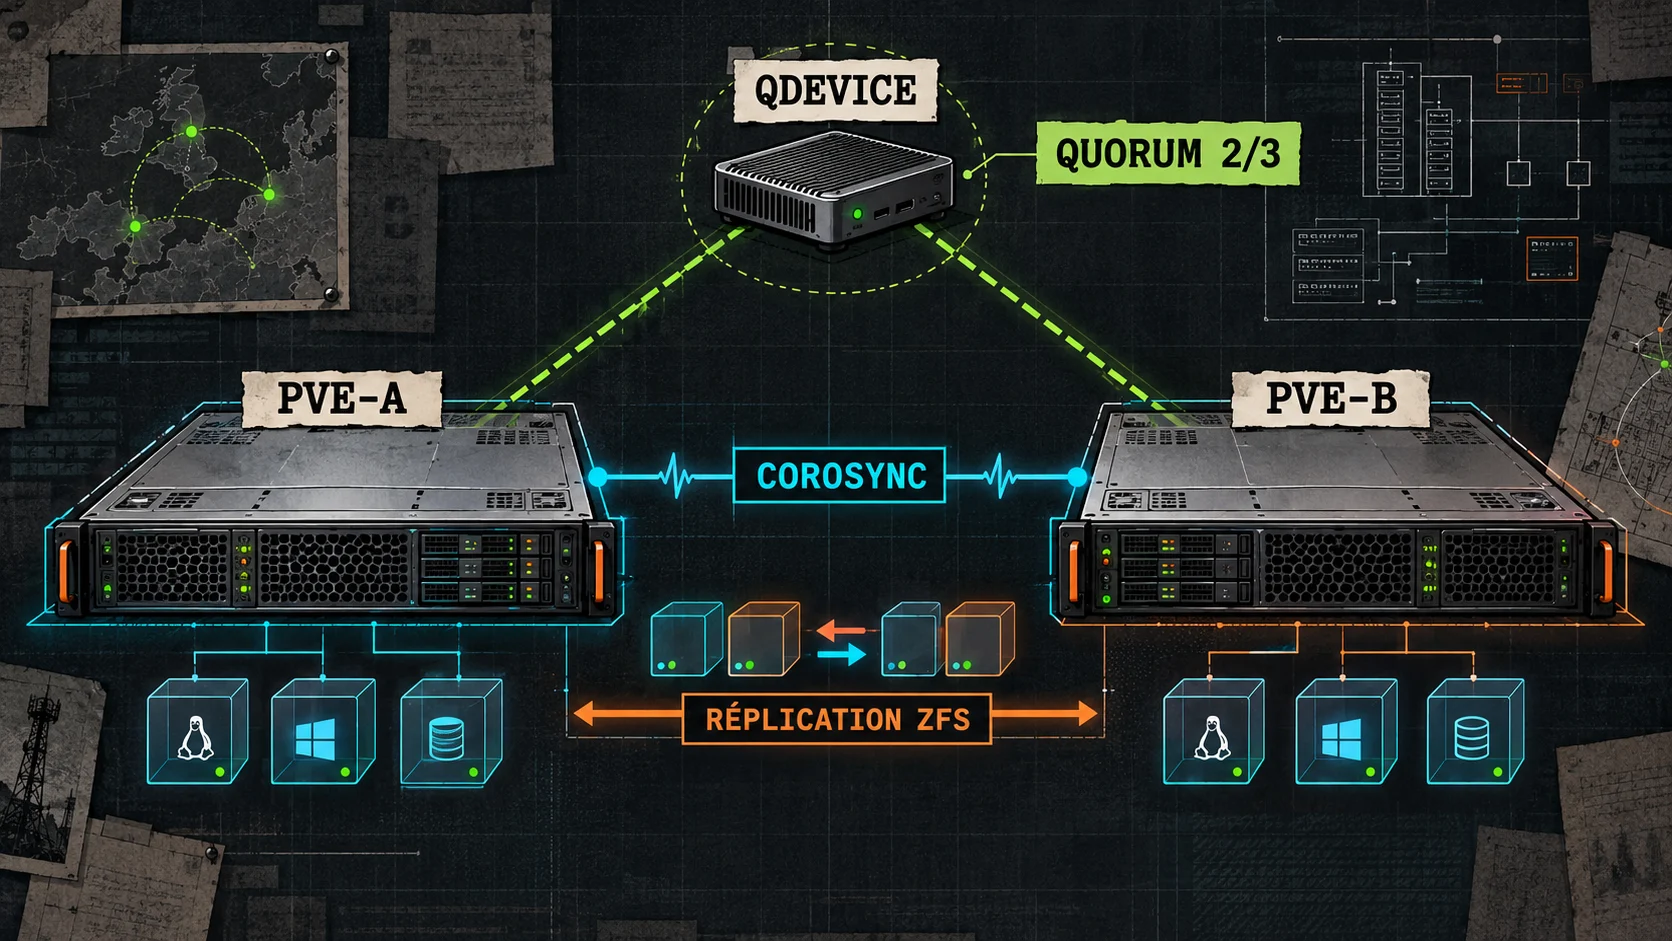
Créer un cluster Proxmox à deux nœuds sans sacrifier le quorum
Créer un cluster Proxmox VE à deux nœuds, ajouter un QDevice, migrer les VM, répliquer les volumes ZFS et préparer une récupération sûre après une panne.
Un cluster Proxmox VE à deux nœuds est séduisant : deux serveurs apparaissent dans la même interface, les machines virtuelles peuvent migrer de l’un à l’autre et ZFS peut répliquer leurs disques sans stockage partagé. Mais deux serveurs ne constituent pas, à eux seuls, une plateforme de haute disponibilité sûre. Lorsqu’un nœud disparaît, le survivant ne peut pas déterminer s’il est réellement seul ou simplement séparé de son partenaire par une panne réseau.
Ce guide montre comment créer le cluster, migrer une VM, configurer la réplication ZFS et surtout ajouter un troisième vote avec un QDevice. Cette distinction est essentielle : deux nœuds facilitent l’administration et la maintenance ; deux nœuds accompagnés d’un arbitre indépendant peuvent prendre des décisions de quorum sans favoriser un split-brain.
Ce que donne réellement un cluster à deux nœuds
Le cluster Proxmox regroupe plusieurs hyperviseurs dans une configuration distribuée. Le système de fichiers pmxcfs réplique les paramètres du centre de données, des utilisateurs, du pare-feu, des stockages et des invités. Depuis l’interface Web de n’importe quel membre, on peut administrer les autres.
Avec deux nœuds, vous obtenez immédiatement :
- une interface d’administration commune et multi-maître ;
- des identifiants de VM et de conteneurs uniques à l’échelle du cluster ;
- la migration à chaud ou hors ligne entre les hôtes ;
- la réplication asynchrone des volumes ZFS locaux ;
- des tâches de sauvegarde, des permissions et des règles distribuées.
En revanche, le cluster ne crée pas automatiquement un stockage partagé, ne transforme pas une réplication en sauvegarde et n’active pas une haute disponibilité fiable sans quorum. Les ressources HA doivent être configurées séparément, et leurs disques doivent être accessibles sur le nœud qui les reprend.
Pourquoi le quorum bloque le nœud survivant
Corosync attribue normalement une voix à chaque nœud. Dans un cluster de deux membres, le total est de deux voix et la majorité en exige deux. Si la communication est rompue, chaque serveur ne voit plus qu’une voix. Le système de fichiers du cluster passe alors en lecture seule afin d’empêcher les deux côtés de modifier simultanément la même configuration.
Ce comportement n’est pas une panne du cluster : c’est sa protection principale contre le split-brain. Sans arbitre, aucun serveur ne peut savoir si l’autre est éteint ou toujours actif derrière un lien réseau défaillant.
| Architecture | Voix | Majorité | Panne d’un nœud |
|---|---|---|---|
| 2 nœuds seuls | 2 | 2 | Le survivant perd le quorum |
| 2 nœuds + QDevice | 3 | 2 | Le survivant peut recevoir la voix de l’arbitre |
| 3 nœuds Proxmox | 3 | 2 | Deux nœuds conservent naturellement le quorum |
Le QDevice n’héberge aucune VM et ne stocke pas les disques du cluster. Il fournit un vote externe à une seule partition du cluster. Un petit système Debian indépendant suffit, à condition qu’il reste joignable par les deux nœuds. Évitez de placer cet arbitre dans une VM hébergée par le cluster qu’il doit départager.
Préparer les deux serveurs
Avant de cliquer sur « Créer un cluster », vérifiez les points suivants :
- Versions identiques : mettez les deux hôtes à jour et utilisez la même génération de Proxmox VE.
- Noms uniques et résolus : chaque hôte doit résoudre le nom et l’adresse de l’autre, sans modification future du nom d’hôte.
- Adresses fixes : réservez une adresse stable à chaque lien Corosync.
- Heure synchronisée : vérifiez NTP sur les deux serveurs.
- Réseau fiable : Corosync utilise UDP 5405 à 5412 et l’ajout d’un nœud nécessite SSH sur TCP 22.
- Nœud à joindre vide : il ne doit contenir aucune VM ni aucun conteneur.
- Stockages cohérents : utilisez les mêmes identifiants de stockage et, pour la réplication, des pools ZFS compatibles sur les deux hôtes.
- Sauvegarde vérifiée : exportez les configurations et sauvegardez les invités avant toute opération de cluster.
Un réseau Corosync séparé n’est pas strictement obligatoire dans un petit laboratoire, mais il devient vivement conseillé dès que les migrations, les sauvegardes et le stockage génèrent beaucoup de trafic. Si deux liens sont configurés, ils doivent emprunter des chemins réellement distincts : deux VLAN sur le même commutateur ne protègent pas d’une panne de ce commutateur.
1. Créer le cluster sur le premier nœud
Connectez-vous à l’interface Web du premier serveur, puis ouvrez Centre de données → Cluster → Créer un cluster. Choisissez un nom court sans espace, par exemple Prox, et sélectionnez l’adresse du réseau utilisée par Corosync.

La même opération peut être effectuée depuis le shell du premier nœud :
pvecm create Prox --link0 192.168.68.31Contrôlez ensuite l’état du cluster :
pvecm status
pvecm nodes
À ce stade, un seul nœud est membre et l’interface propose le bouton Informations de connexion. Copiez le bloc fourni : il contient l’adresse du membre existant, l’empreinte de son certificat et les informations nécessaires à l’ajout.
2. Rejoindre le cluster depuis le second nœud
Ouvrez l’interface Web du second serveur, puis Centre de données → Cluster → Rejoindre le cluster. Collez les informations copiées, saisissez le mot de passe root du premier nœud et sélectionnez l’adresse locale du lien Corosync.

192.168.68.31 et le second nœud présente son lien local 192.168.68.32.Depuis le shell du second nœud, l’équivalent est :
pvecm add 192.168.68.31 --link0 192.168.68.32La session Web du second nœud s’interrompt normalement pendant l’intégration : son certificat est remplacé par un certificat signé par l’autorité du cluster. Attendez quelques instants, rechargez complètement la page et reconnectez-vous avec les identifiants du cluster.
Les deux nœuds doivent maintenant apparaître sous le même centre de données. Vérifiez de nouveau pvecm status. Sans QDevice, le cluster est opérationnel lorsque les deux hôtes communiquent, mais il perdra le quorum dès que l’un d’eux ou le lien qui les relie disparaît.
3. Ajouter le troisième vote avec QDevice
Préparez une petite machine indépendante sous Debian ou une distribution proposant corosync-qnetd. Elle peut être peu puissante : son rôle consiste seulement à arbitrer. Placez-la de préférence sur une alimentation et un chemin réseau distincts de ceux des deux hyperviseurs.
Sur l’arbitre :
apt update
apt install corosync-qnetd
Sur les deux nœuds Proxmox :
apt update
apt install corosync-qdevice
Puis, depuis un membre du cluster, configurez l’arbitre :
pvecm qdevice setup 192.168.68.50Remplacez l’adresse par celle de votre arbitre. La commande prépare les certificats et enregistre le vote externe. Une nouvelle exécution de pvecm status doit montrer trois voix au total et un quorum fixé à deux.
4. Migrer une machine virtuelle
Faites un clic droit sur la VM, choisissez Migrer, puis sélectionnez le nœud cible. La migration à chaud conserve la VM en fonctionnement pendant le transfert de sa mémoire et, lorsque les disques sont locaux, de ses volumes.

local-zfs doivent être copiés vers le nœud cible.La durée dépend du stockage et du réseau :
- Stockage partagé : les disques restent en place et seuls l’état de la VM, la mémoire modifiée et les périphériques virtuels doivent basculer.
- Stockage local : Proxmox copie les volumes sur le stockage cible, ce qui peut transférer plusieurs centaines de gigaoctets.
- ZFS déjà répliqué : la majorité des blocs existe déjà sur la cible et seuls les changements depuis la dernière réplication doivent être envoyés.
Les ponts réseau doivent porter les mêmes noms sur les deux hôtes. Pour des processeurs différents, choisissez un modèle de CPU virtuel compatible avec les deux machines plutôt que host. Le QEMU Guest Agent est recommandé pour les opérations propres dans l’invité, mais il n’est pas une condition absolue de la migration à chaud.
5. Répliquer les disques ZFS
La réplication Proxmox fonctionne avec les volumes ZFS locaux. Elle crée des instantanés, envoie une première copie complète, puis ne transfère que les blocs modifiés. Dans la VM concernée, ouvrez Réplication → Ajouter, choisissez le nœud cible et définissez la planification.

La première synchronisation est la plus longue. Les suivantes sont incrémentales et leur fréquence ne multiplie pas automatiquement l’espace occupé par autant de copies complètes. Une limite de bande passante peut empêcher la réplication d’étouffer le trafic des utilisateurs.
Après une migration vers le nœud de réplication, Proxmox inverse automatiquement la direction de la tâche. La nouvelle machine source renvoie alors ses changements vers l’ancien hôte. Contrôlez régulièrement l’état et le journal de la tâche : une réplication définie mais en erreur ne constitue aucune protection.
Que se passe-t-il lorsqu’un nœud tombe en panne ?
La réponse dépend de trois éléments : le quorum, la disponibilité des disques et l’activation de HA.
- Deux nœuds avec QDevice et HA : le survivant peut conserver le quorum et redémarrer les ressources HA dont les volumes sont disponibles.
- Deux nœuds avec QDevice, sans HA : le cluster reste modifiable, mais le redémarrage de la VM demeure une opération manuelle.
- Deux nœuds sans QDevice : le survivant perd le quorum et
/etc/pvedevient en pratique non modifiable. - ZFS répliqué : le disque disponible sur la cible correspond à la dernière synchronisation réussie ; les écritures postérieures sont perdues.
Avant toute récupération manuelle, assurez-vous que le nœud défaillant est réellement hors tension ou isolé du stockage et du réseau du cluster. Ce fencing évite que deux instances de la même VM accèdent aux mêmes données.
Utiliser pvecm expected 1 uniquement en urgence
Sans QDevice, il est possible d’abaisser temporairement le nombre de voix attendues sur l’unique survivant :
pvecm status
pvecm expected 1
Cette commande sert à une récupération d’urgence, pas à l’exploitation quotidienne. Ne l’exécutez que si le second nœud est confirmé éteint et ne peut pas se reconnecter pendant l’intervention. Effectuez le minimum nécessaire, réparez ensuite le quorum normal et ne remettez jamais les deux côtés en ligne avec des états divergents.
Pour une VM non gérée par HA dont tous les disques sont déjà accessibles depuis le survivant, la documentation Proxmox permet de déplacer son fichier de configuration vers le répertoire du nœud actif. Exemple pour la VM 100 :
mv /etc/pve/nodes/pve-b/qemu-server/100.conf \
   /etc/pve/nodes/pve-a/qemu-server/
N’utilisez pas cette commande si les disques ne sont pas présents et cohérents sur pve-a. Elle change le propriétaire logique de la configuration ; elle ne copie pas les données. Pour un invité géré par HA, laissez le gestionnaire HA et le mécanisme de fencing effectuer la récupération.
Pourquoi il ne faut pas donner deux voix permanentes à un nœud
Modifier /etc/pve/corosync.conf afin d’attribuer deux voix à un hôte « principal » semble résoudre le blocage lorsque l’autre serveur est arrêté. En réalité, cette asymétrie transforme le premier nœud en arbitre de sa propre partition et fragilise le modèle de sécurité du cluster.
Si le réseau se coupe alors que les deux machines fonctionnent, le nœud privilégié peut continuer à écrire tandis que l’autre voit une situation différente. Une erreur de stockage, un démarrage inattendu ou une restauration de configuration peut alors créer des états contradictoires. Le QDevice existe précisément pour confier la troisième voix à un système indépendant capable de n’élire qu’un seul côté.
Plan de validation avant la production
- Vérifiez
pvecm statuset la présence des trois voix avec QDevice. - Testez une migration à chaud dans les deux directions.
- Créez une réplication courte, contrôlez son journal puis migrez la VM pour vérifier l’inversion de direction.
- Arrêtez proprement un nœud de test et confirmez que le survivant reste quorate.
- Testez la perte du QDevice seul : les deux hyperviseurs réunis doivent continuer à fonctionner.
- Vérifiez l’ordre de démarrage, les délais d’arrêt et le QEMU Guest Agent des VM importantes.
- Restaurez une sauvegarde sur un identifiant de test avant de considérer le plan comme validé.
- Documentez les adresses, liens Corosync, stockages, dépendances et procédures de fencing.
Conclusion
Un cluster Proxmox à deux nœuds est très utile pour centraliser l’administration, déplacer les VM et répliquer des volumes ZFS. Il ne faut cependant pas confondre ces fonctions avec une haute disponibilité complète. Sans troisième vote, la perte d’un membre immobilise volontairement le survivant pour protéger la cohérence.
La bonne architecture compacte est donc claire : deux nœuds Proxmox équivalents, un réseau Corosync fiable, des stockages cohérents, un QDevice indépendant, des réplications surveillées et des sauvegardes séparées. La disponibilité vient de l’ensemble de ces mécanismes, pas du simple fait que deux serveurs apparaissent sous le même centre de données.
Références techniques
À lire ensuite


À propos de l’auteur
 Jeremy Kraft administre les infrastructures et les services auto-hébergés de l’IBCSC. Ces guides reprennent des configurations réellement déployées, revérifiées avant publication.
Discussion
Commentaires
Aucun commentaire pour le moment. Vous pouvez ouvrir la discussion avec une question ou un retour d’expérience.