OSINT, KI & Social Engineering
Was KI in einer Minute über Sie herausfinden kann
Künstliche Intelligenz erfindet keine neue Überwachung: Sie verwandelt verstreute öffentliche Spuren in ein verwertbares Profil und senkt so die Kosten eines gezielten Angriffs. Was sich dadurch ändert – und wie Sie die Initiative zurückgewinnen.
 Jeremy Kraft · 10 Min. Lesezeit
In diesem Artikel
Bis vor Kurzem erforderte es Methode, Sprachkenntnisse, Geduld und ein gutes Gedächtnis, das digitale Porträt eines Unbekannten zu erstellen. Man musste nach einem alten Nutzernamen suchen, Fotos vergleichen, Archive lesen, eine Chronologie rekonstruieren und Zufall von echtem Zusammenhang unterscheiden. Diese Arbeit ist nicht verschwunden. Ein Teil ihrer Kosten ist jedoch gerade eingebrochen.
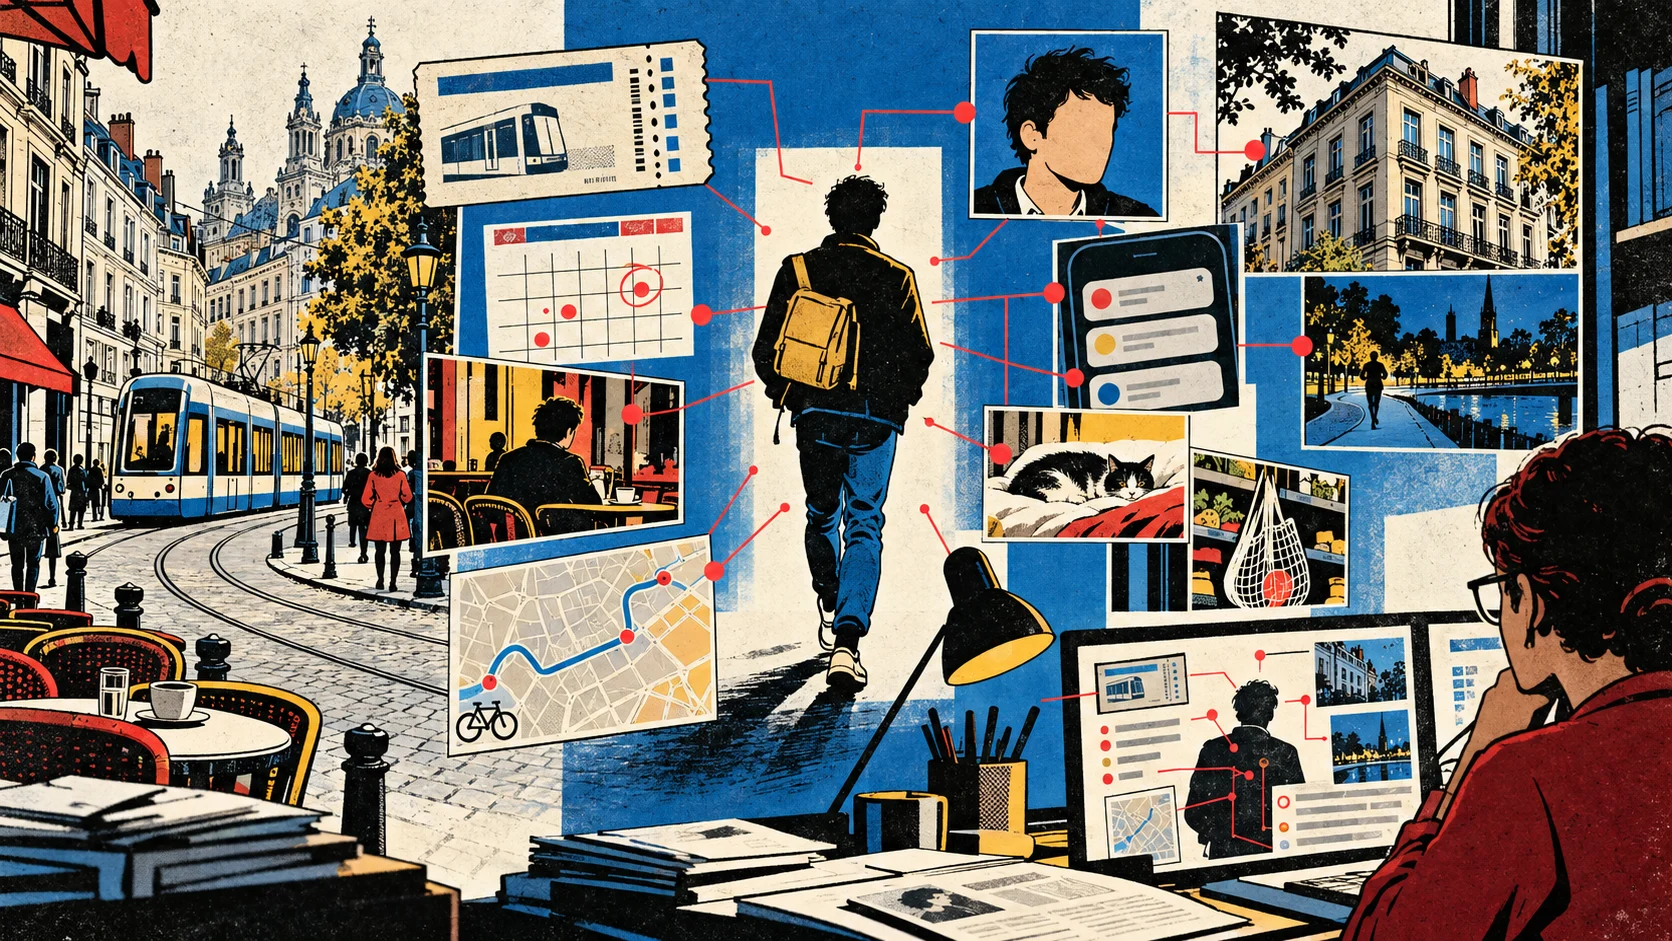
Eine mit dem Web verbundene KI kann heute Suchanfragen in mehreren Sprachen vorschlagen, jahrelange Beiträge zusammenfassen, Nutzernamen miteinander abgleichen, Details aus einem Bild herauslesen und einen Berg von Ergebnissen in eine stimmige Erzählung verwandeln. Sie verfügt nicht unbedingt über eine geheime Datenbank zu jedem von uns. Ihre Macht beruht vielmehr darauf, sehr schnell zusammenzuführen, was bereits sichtbar war, aber zu verstreut, um aufzufallen.
Das ist ein bedeutender Umbruch. Das Risiko betrifft nicht mehr nur Personen des öffentlichen Lebens oder Recherchen mit großem Budget. Eine E-Mail-Adresse, ein mehrfach verwendeter Nutzername, einige Fotos und ein Berufsprofil können genügen, um eine Suche anzustoßen. KI macht OSINT nicht unfehlbar; sie macht es industrialisierbar.
Die Maschine entdeckt Ihr Leben nicht: Sie verkürzt die Lesezeit
OSINT – Aufklärung aus offenen Quellen – bedeutet nicht, ein Konto zu knacken oder in ein System einzudringen. Es nutzt zugängliche Informationen: Websites, Register, soziale Netzwerke, Artikel, öffentliche Dokumente, Karten, Bilder, Videos und Metadaten. Menschliche Ermittler bleiben besser darin, eine mehrdeutige Situation zu verstehen, eine Quelle einzuschätzen und zu spüren, was nicht passt. Die Maschine dagegen glänzt bei der Wiederholung.
Sie kann einen Namen umformulieren, Schreibvarianten testen, eine Suchanfrage übersetzen, dieselben Interessen auf mehreren Plattformen erkennen, Daten ordnen und Spuren vorschlagen. Die entscheidende Veränderung liegt weniger in einer geheimnisvollen Fähigkeit als in der Verdichtung der Arbeit: Dutzende früher manuelle Kleinstaufgaben werden nun in einem einzigen Gespräch aneinandergereiht.
Diese Automatisierung verändert auch den Maßstab. Eine sehr gezielte Recherche kostete Zeit und blieb daher Zielen vorbehalten, die als wichtig galten. Wird sie billig, lässt sie sich für Hunderte oder Tausende Menschen wiederholen. Das Profil muss nicht einmal perfekt sein. Einem Betrüger genügt es oft, wenn es genug wahre Details enthält, um die nächste Nachricht glaubwürdig zu machen.
Eine E-Mail-Adresse kann der Anfang eines Drehbuchs sein
Eine auf der USENIX Security 2025 vorgestellte Studie testete Agenten, die von einer einzigen E-Mail-Adresse ausgehend öffentliche Informationen über deren Inhaber suchen und anschließend einen passenden Köder erstellen konnten. Am beunruhigendsten ist nicht die sprachliche Qualität des Ergebnisses, sondern die automatische Abfolge von Recherche, Wahl eines Vorwands und Personalisierung.
2026 maß ein Experiment mit 7.700 Teilnehmenden diesen Effekt in größerem Maßstab. Von Sprachmodellen personalisierte Nachrichten verdreifachten die Klickrate gegenüber generischen Kampagnen nahezu. Die Forschenden schätzen die Kosten der Personalisierung auf etwa drei US-Cent pro Empfänger.
Diese Zahl verändert die Ökonomie des Phishings. Der Angreifer muss nicht mehr zwischen einer industriellen, wenig glaubwürdigen Nachricht und einer aufwendigen Handarbeit wählen. Er kann einen Teil von beidem automatisieren: die Reichweite der ersten und die Präzision der zweiten.
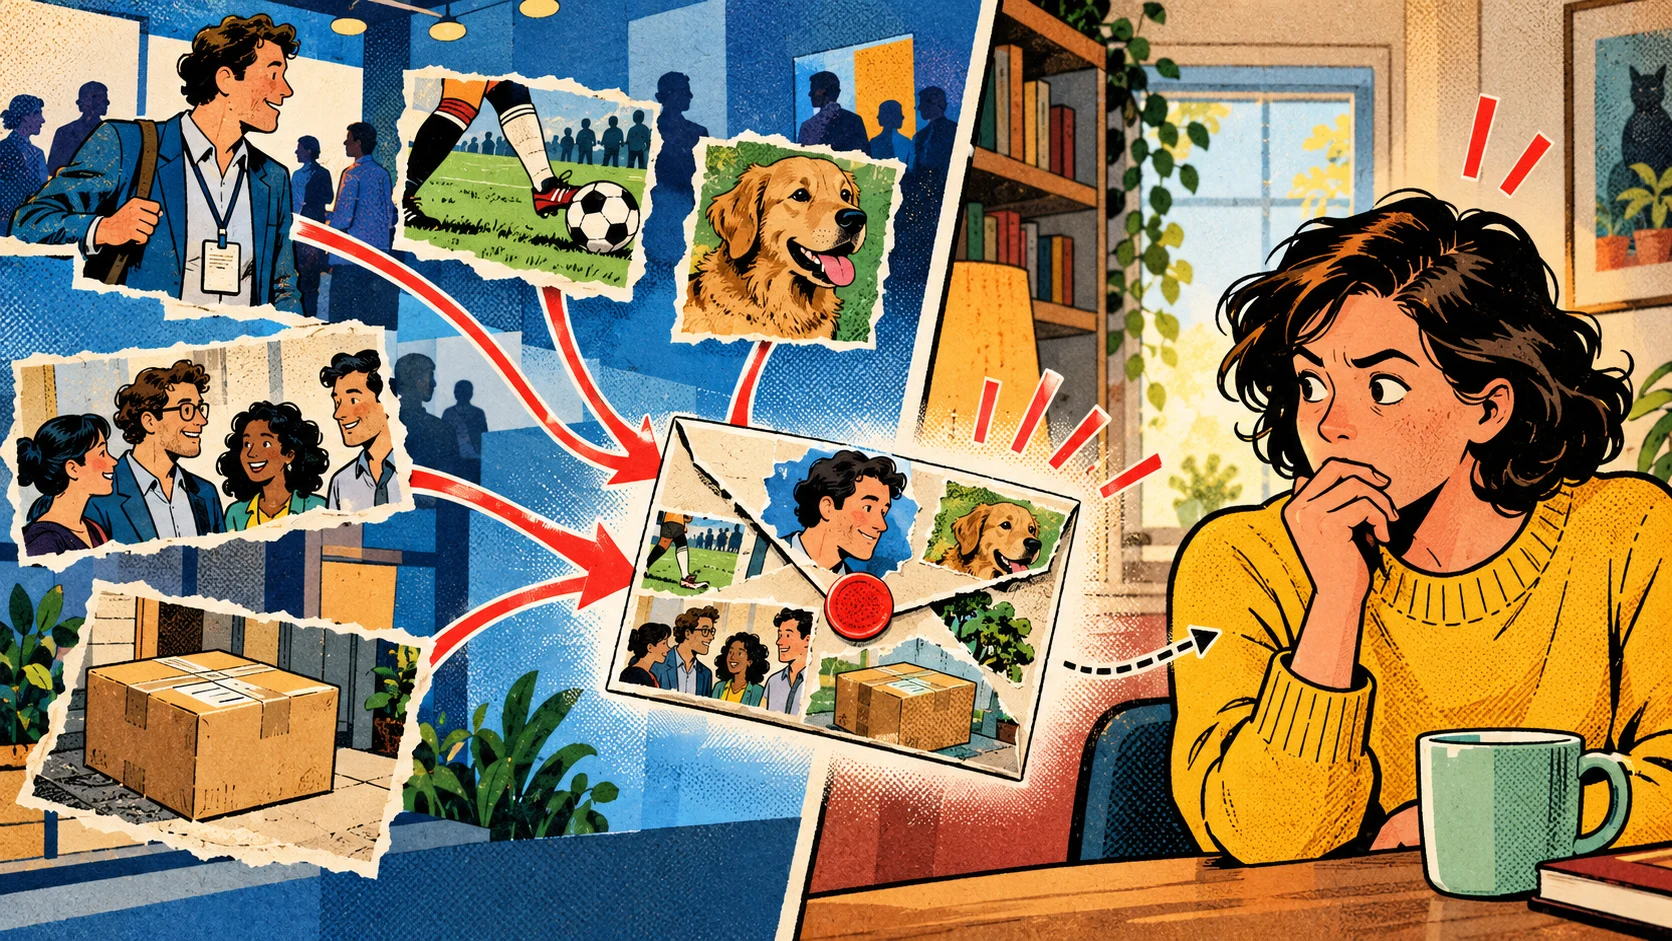
Die Nachricht kann das Thema einer Konferenz aufgreifen, an der die Person teilgenommen hat, den Namen eines Kollegen, ein Hobby, eine Reise oder einen Dienst, den sie tatsächlich nutzt. Keines dieser Elemente ist zwangsläufig geheim. Ihre Kombination erzeugt dennoch den Eindruck von Legitimität: „Wer das weiß, muss die richtige Person sein.“ Genau auf diesen Fehler zielt der Angriff ab.
Ein banales Foto kann wie eine Landkarte funktionieren
Die Geolokalisierung veranschaulicht diesen Wandel noch besser. Ein Bild muss kein berühmtes Bauwerk zeigen, um Hinweise zu enthalten. Die Form eines Fensters, die Farbe eines Kennzeichens, der Backstein einer Fassade, Fahrbahnmarkierungen, Straßenbahnleitungen, Vegetation, Schatten oder das Modell eines Müllcontainers können das mögliche Gebiet schrittweise eingrenzen.
Arbeiten wie LLMGeo haben gezeigt, dass multimodale Modelle solche Signale auf Aufnahmen aus mehreren Ländern kombinieren können. Das Werkzeug wird so zu einem Generalisten, der in einer einzigen Analyse Wissen über Architektur, Botanik, Verkehr, Klima und Beschilderung heranziehen kann, das ein einzelner Mensch selten in sich vereint.

Dabei gilt es jedoch, einer Falle zu widerstehen: Eine detaillierte Erklärung ist kein Beweis. Der auf der ACL 2026 veröffentlichte Benchmark GeoRC stellt fest, dass einige große Modelle beim Vorschlagen eines Landes oder einer Region mit menschlichen Experten mithalten, aber weiterhin Hinweise erfinden, um ihre Antwort zu rechtfertigen – eine nicht vorhandene Aufschrift, falsch erkannte Infrastruktur oder eine imaginäre Pflanze.
Eine Standorthypothese muss daher eine Hypothese bleiben, bis sie durch unabhängige Quellen bestätigt ist. Im professionellen Einsatz muss jeder Hinweis beobachtbar, dokumentiert und reproduzierbar sein. Ohne diese Disziplin liefert KI keine Erkenntnisse, sondern eine überzeugende Geschichte.
Ein falsches Dossier ist manchmal so gefährlich wie ein echtes
Die automatische Zusammenfassung fügt eine weitere Schwäche hinzu. Indem das Modell Nutzernamen, Uhrzeiten oder Beziehungen verknüpft, kann es ein echtes Muster sichtbar machen. Es kann aber auch zwei Personen mit demselben Namen verschmelzen, ein Foto dem falschen Konto zuordnen oder eine Korrelation in eine Gewissheit verwandeln.
Für die betroffene Person ist der Fehler nicht unbedingt beruhigend. Ein Dossier aus 80 % zutreffenden Fakten und 20 % Erfindungen kann genügen, um einen Betrug, eine Belästigungskampagne, eine Einstellungsentscheidung oder eine Anschuldigung zu lenken. Je flüssiger die Darstellung, desto eher vergisst der Leser, dass der Text Quellen unterschiedlicher Qualität zusammenfasst.
Man muss daher drei Ebenen unterscheiden: was direkt beobachtet wird, was abgeglichen ist und was nur gefolgert wird. Ein seriöses System nennt seine Quellen, bewahrt Widersprüche und drückt Unsicherheit aus. Ein Chatbot für Verbraucher neigt dagegen dazu, Lücken zu glätten, um eine angenehm lesbare Antwort zu liefern.
Dasselbe Werkzeug dient der Recherche und dem Angriff
Ein Journalist kann diese Fähigkeiten nutzen, um die Herkunft eines Bildes zu ermitteln. Ein Sicherheitsteam kann die öffentliche Angriffsfläche seiner Organisation kartieren. Eine Person kann ihren eigenen digitalen Fußabdruck prüfen. Dieselben Funktionen können dazu dienen, einen Identitätsbetrug vorzubereiten, eine Routine auszuspähen oder den Vorwand für eine betrügerische Nachricht zu wählen.
Der Unterschied liegt in der Befugnis, dem Zweck, der Verhältnismäßigkeit und dem Umgang mit den Daten – nicht im Werkzeug. Deshalb können die in Modelle eingebauten Schutzmechanismen das Problem nicht allein lösen. Eine scheinbar harmlose Anfrage kann Teil einer legitimen Recherche oder einer feindlichen Operation sein; eine Weigerung kann mitunter den Profi blockieren, ohne einen Akteur aufzuhalten, der über ein anderes Modell oder einen spezialisierten Dienst verfügt.
Das britische National Cyber Security Centre geht davon aus, dass KI bereits heute die Ausspähung von Opfern, Social Engineering und die schnelle Verarbeitung gestohlener Daten verbessert. Vor allem erwartet es eine Steigerung der Effizienz und des Umfangs bestehender Techniken statt des plötzlichen Auftauchens eines völlig neuen Angriffs. Europol kommt zum selben Befund: Generative Modelle machen Betrugsmaschen besser auf den kulturellen Kontext und die persönlichen Informationen des Ziels zugeschnitten.
Mit anderen Worten: Die nächstliegende Gefahr ist keine allwissende Superintelligenz. Es ist ein alter Betrug, der aufmerksamer, besser formuliert und viel billiger geworden ist.
Das eigene digitale Spiegelbild prüfen
Die eigene Angriffsfläche zu verringern, beginnt mit einer Bestandsaufnahme, nicht mit Panik. Ziel ist nicht, zu verschwinden – ein unrealistisches Versprechen –, sondern zu verstehen, welche Teile sich zusammensetzen lassen.
- Suchen Sie nach Ihrem Namen, seinen Varianten, Ihren üblichen Nutzernamen und den E-Mail-Adressen, die Sie öffentlich verwenden. Tun Sie das in den relevanten Sprachen und Schriften und nach Möglichkeit ohne angemeldet zu sein.
- Betrachten Sie die Ergebnisse wie ein Fremder: Lassen sich damit Wohnort, Arbeitsplatz, Umfeld, Tagesabläufe, Reisen, Hobbys oder Abwesenheitszeiten verknüpfen?
- Prüfen Sie Originalfotos vor der Veröffentlichung. Der Hintergrund, eine Spiegelung, ein Kennzeichen, ein Ausweis, ein Paket oder der Blick aus einem Fenster können aufschlussreicher sein als das eigentliche Motiv. Entfernen Sie Standort-Metadaten, wenn sie nicht nötig sind.
- Verwenden Sie nicht überall denselben Nutzernamen und dieselbe E-Mail-Adresse. Die Trennung von beruflicher, behördlicher, kommerzieller und öffentlicher Nutzung erschwert automatische Verknüpfungen.
- Schließen Sie alte Konten, korrigieren Sie veraltete Profile und beantragen Sie die Löschung von Informationen, die keinen Grund mehr haben, öffentlich zu sein.
In Belgien und der Europäischen Union ist das Recht auf Löschung nicht absolut, bietet aber konkrete Hebel. Die belgische Datenschutzbehörde erläutert die Auslistung und empfiehlt, sich zuerst an den Herausgeber oder die Quelle und dann an die Suchmaschine zu wenden. Eine Auslistung entfernt nicht immer den ursprünglichen Inhalt, verringert aber dessen Sichtbarkeit bei einer Suche nach Ihrem Namen.
Es lohnt sich, diese Prüfung zu wiederholen. Ein gelöschtes Ergebnis kann kopiert worden sein, eine Plattform kann ihre Einstellungen ändern, und ein neues Datenleck kann bislang getrennte Elemente verknüpfen. Der Schutz der digitalen Identität ist eine laufende Pflege, kein einmaliger Großputz.
Eine Nachricht nicht mehr an ihrer Grammatik messen
Grobe Fehler sind kein verlässlicher Filter mehr. Eine betrügerische Nachricht kann tadellos geschrieben, an die Sprache des Empfängers angepasst und mit zutreffenden Details angereichert sein. Die richtige Frage lautet daher nicht mehr „Wirkt diese Nachricht professionell?“, sondern „Habe ich diese Anfrage erwartet, und kann ich sie anderweitig überprüfen?“.
Eine dringende Bitte um eine Zahlung, ein Dokument, einen Code oder eine Anmeldung muss über einen bereits bekannten Kanal überprüft werden: die offizielle App, eine gespeicherte Nummer oder ein separates Gespräch. Antworten Sie nicht auf die Nachricht, um zu fragen, ob sie echt ist, und verwenden Sie nicht die darin angegebene Nummer. Bei heiklen Anfragen unter Angehörigen oder Kollegen kann zudem ein offline vereinbartes Codewort verhindern, dass eine überzeugende Imitation ausreicht.
Aktivieren Sie die Mehr-Faktor-Authentifizierung, beginnend mit Ihrem Haupt-E-Mail-Konto. Safeonweb empfiehlt 2FA, unterschiedliche Passwörter und einen Passwort-Manager. Bei einer verdächtigen Nachricht rät die belgische Plattform, dem Link nicht zu folgen, über die offizielle Website oder Nummer nachzuprüfen und die Nachricht an suspect@safeonweb.be weiterzuleiten.
Organisationen müssen den Kontext schützen, nicht nur die Konten
Ein Unternehmen kann sein E-Mail-System absichern und zugleich Organigramm, Lieferanten, Reisen, Projekte, Signaturen und Gewohnheiten veröffentlichen, die einen Identitätsbetrug glaubwürdig machen. Risikominderung bedeutet nicht, auf jede Transparenz zu verzichten. Sie besteht darin zu prüfen, was sich aus mehreren Veröffentlichungen zusammen ableiten lässt.
Teams sollten die je Funktion offengelegten Informationen kartieren, wirklich personalisierte Szenarien in Sensibilisierungsübungen aufnehmen und eine unabhängige Überprüfung für Zahlungen, Änderungen von Bankverbindungen, Datenexporte und dringende Anfragen der Geschäftsleitung vorschreiben. Öffentliche Verzeichnisse sollten zeigen, was nötig ist, und nicht als fertige Datenbank für die Zielauswahl dienen.
Sie müssen auch ihre eigene KI-Nutzung regeln. Eine Mitarbeiterliste, eine Kundenakte oder während einer Untersuchung gesammelte Daten in einen Verbraucherdienst einzufügen, kann eine neue Offenlegung schaffen. Ein defensives Audit bleibt eine Datenverarbeitung: Es braucht einen Zweck, einen Rahmen, beschränkten Zugriff, eine Aufbewahrungsfrist und eine menschliche Freigabe.
Was sich wirklich ändert
KI hat die Anonymität nicht über Nacht abgeschafft. Sie hat es viel leichter gemacht, Bruchstücke zusammenzusetzen, die Internetnutzer, ihre Angehörigen, ihre Arbeitgeber und ihre Geräte bereits veröffentlicht hatten. Ihre Stärke liegt nicht darin, alles zu wissen, sondern zu wissen, wo man suchen, was man verknüpfen und wie man das Ergebnis überzeugend präsentieren muss.
Diese Nuance führt zu einer realistischeren Verteidigung. Es geht nicht darum, auf jede Online-Präsenz zu verzichten, und auch nicht darum zu glauben, ein Knopf werde die Vergangenheit löschen. Es geht darum, unnötige Brücken zwischen unseren verschiedenen Lebensbereichen abzubauen, Anfragen statt ihres Stils zu überprüfen und jede Veröffentlichung nicht nur danach zu beurteilen, was sie heute sagt, sondern danach, was eine Maschine morgen daraus ableiten kann.
Redaktionelle Angaben
- Verfasst von
- Jeremy Kraft
- Zuletzt geprüft
- Methode
- Öffentliche Quellen, redaktionelle Prüfung und verhältnismäßige Empfehlungen.


Diskussion
Kommentare
Noch kein Kommentar. Eröffnen Sie die Diskussion gern mit einer Frage oder Ihrem eigenen Erfahrungsbericht.