OSINT, IA & ingénierie sociale
Ce que l’IA peut apprendre sur vous en une minute
L’intelligence artificielle n’invente pas une nouvelle surveillance : elle transforme des traces publiques dispersées en profil exploitable, puis réduit le coût d’une attaque ciblée. Voici ce que cela change — et comment reprendre l’initiative.
 Jeremy Kraft · 12 min de lecture
Dans cet article
Il y a encore peu de temps, dresser le portrait numérique d’un inconnu exigeait une méthode, des langues, de la patience et une bonne mémoire. Il fallait chercher un ancien pseudonyme, comparer des photographies, lire des archives, reconstruire une chronologie et distinguer la coïncidence du lien réel. Ce travail n’a pas disparu. Mais une partie de son coût vient de s’effondrer.
Une IA reliée au Web peut désormais proposer des requêtes dans plusieurs langues, résumer des années de publications, rapprocher des noms d’utilisateur, extraire les détails d’une image et transformer un amas de résultats en récit cohérent. Elle ne possède pas nécessairement une base secrète sur chacun de nous. Son pouvoir vient plutôt de sa capacité à réunir, très vite, ce qui était déjà visible mais trop dispersé pour attirer l’attention.
C’est un basculement important. Le risque n’est plus réservé aux personnalités publiques ni aux enquêtes disposant d’un budget conséquent. Une adresse électronique, un pseudonyme réutilisé, quelques photographies et un profil professionnel peuvent suffire à amorcer une recherche. L’IA ne rend pas l’OSINT infaillible ; elle le rend industrialisable.
La machine ne découvre pas votre vie : elle en réduit le temps de lecture
L’OSINT — le renseignement issu de sources ouvertes — ne consiste pas à forcer un compte ou à pénétrer un système. Il exploite des informations accessibles : sites, registres, réseaux sociaux, articles, documents publics, cartes, images, vidéos et métadonnées. L’enquêteur humain reste meilleur pour comprendre une situation ambiguë, évaluer une source et percevoir ce qui ne cadre pas. La machine, elle, excelle dans la répétition.
Elle peut reformuler un nom, tester des variantes orthographiques, traduire une requête, relever les mêmes centres d’intérêt sur plusieurs plateformes, classer des dates et suggérer des pistes. Le changement décisif tient moins à une faculté mystérieuse qu’à la compression du travail : des dizaines de microtâches auparavant manuelles se retrouvent enchaînées dans une seule conversation.
Cette automatisation modifie aussi l’échelle. Une recherche très ciblée coûtait du temps et se réservait donc aux cibles jugées importantes. Lorsqu’elle devient bon marché, elle peut être répétée pour des centaines ou des milliers de personnes. Le profil n’a même pas besoin d’être parfait. Pour un fraudeur, il suffit souvent qu’il contienne assez de détails vrais pour rendre crédible le prochain message.
Une adresse électronique peut devenir le début d’un scénario
Une étude présentée à USENIX Security 2025 a testé des agents capables de partir d’une seule adresse électronique, de rechercher des informations publiques sur son propriétaire puis de fabriquer un leurre adapté. Le point le plus préoccupant n’est pas la qualité littéraire du résultat : c’est l’enchaînement automatique entre recherche, choix d’un prétexte et personnalisation.
En 2026, une expérience menée sur 7 700 participants a mesuré cet effet à plus grande échelle. Les messages personnalisés par des modèles de langage ont presque triplé le taux de clic par rapport à des campagnes génériques. Les chercheurs estiment le coût de la personnalisation à environ trois centimes de dollar par destinataire.
Ce chiffre change la nature économique du phishing. L’attaquant n’a plus à choisir entre un message industriel, peu crédible, et une opération artisanale coûteuse. Il peut automatiser une partie des deux : la portée de la première et la précision de la seconde.
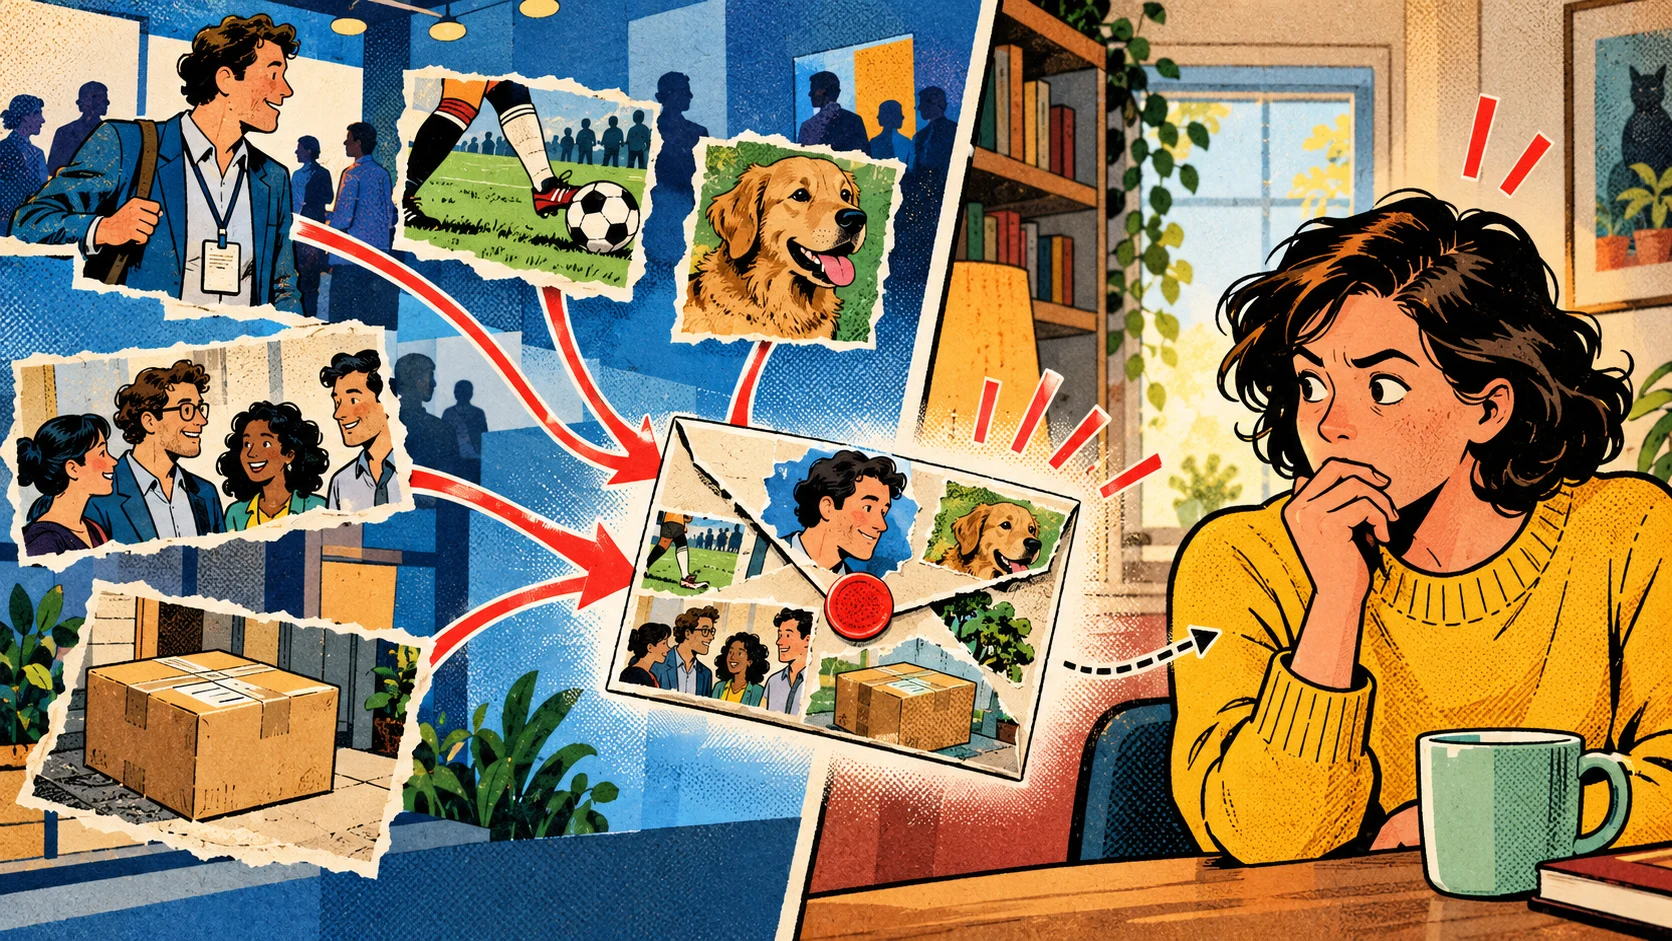
Le message peut reprendre le thème d’une conférence à laquelle la personne a participé, le nom d’un collègue, un loisir, un déplacement ou le service qu’elle utilise réellement. Aucun de ces éléments n’est forcément secret. Leur combinaison crée pourtant une impression de légitimité : « quelqu’un qui connaît cela doit être la bonne personne ». C’est précisément l’erreur recherchée.
Une photographie banale peut fonctionner comme une carte
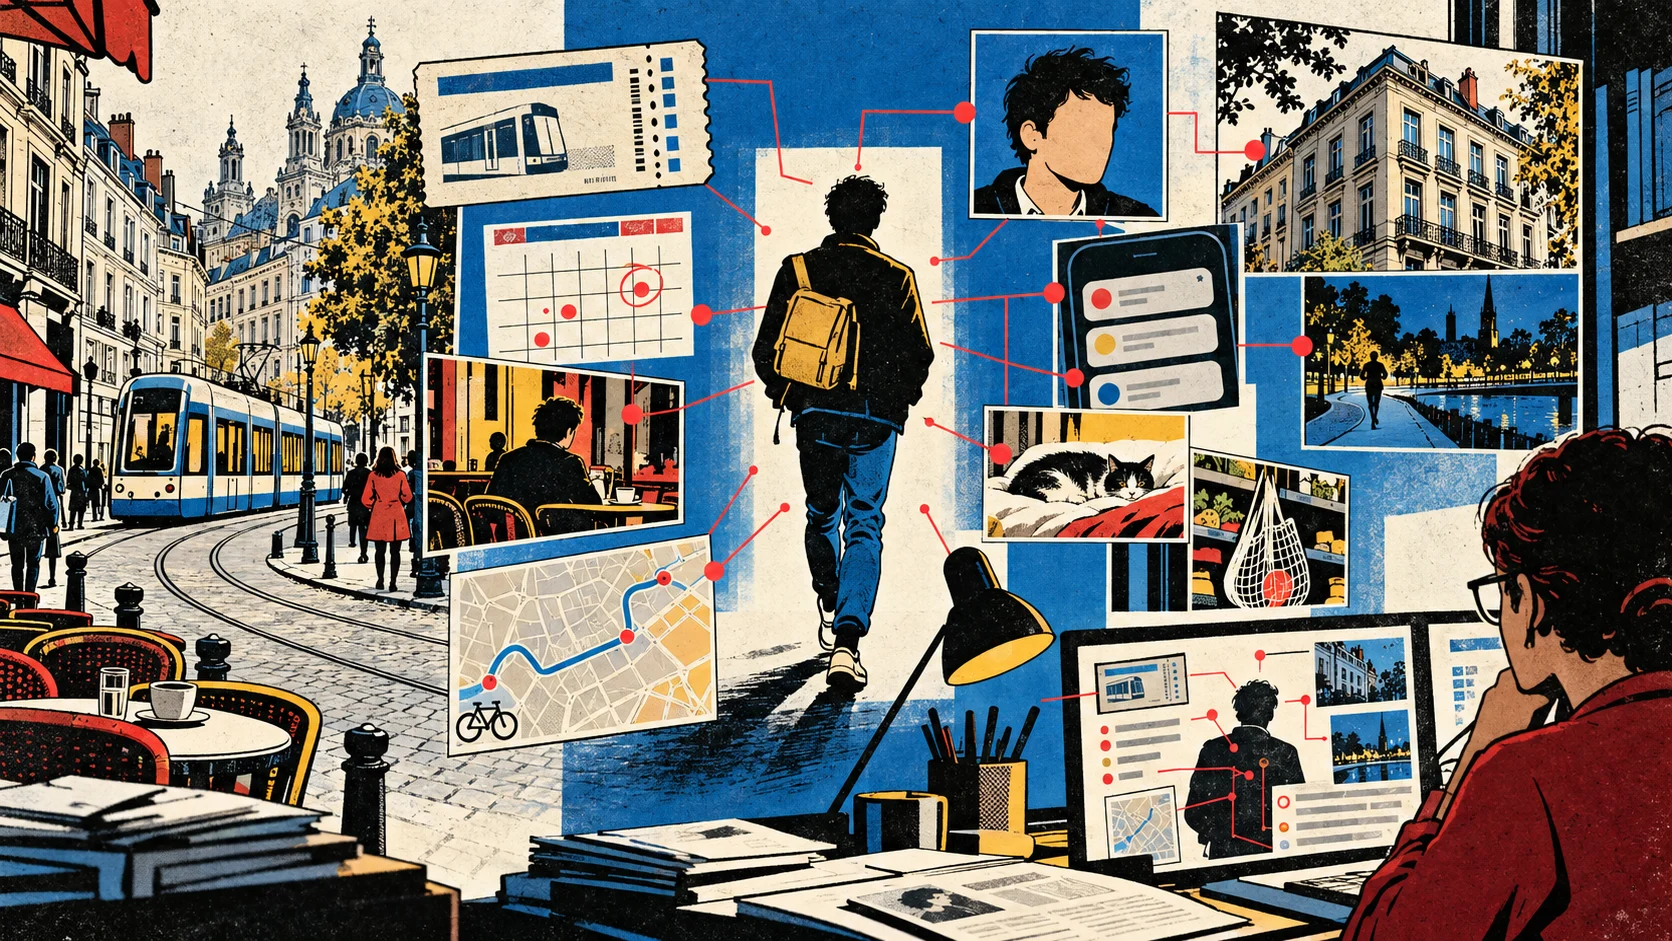
La géolocalisation illustre encore mieux ce changement. Une image ne doit pas montrer un monument célèbre pour contenir des indices. La forme d’une fenêtre, la couleur d’une plaque, la brique d’une façade, le marquage routier, les câbles d’un tram, la végétation, l’ombre ou le modèle d’un conteneur peuvent réduire progressivement la zone possible.
Des travaux comme LLMGeo ont montré que des modèles multimodaux peuvent combiner ce type de signaux sur des scènes prises dans plusieurs pays. L’outil devient alors un généraliste capable de mobiliser, dans la même analyse, des connaissances d’architecture, de botanique, de transport, de climat et de signalisation qu’un seul humain possède rarement toutes à la fois.

Il faut toutefois résister à un piège : une explication détaillée n’est pas une preuve. Le benchmark GeoRC publié à l’ACL 2026 constate que certains grands modèles rivalisent avec des experts humains pour proposer un pays ou une région, mais qu’ils inventent encore des indices pour justifier leur réponse — une inscription inexistante, une infrastructure mal identifiée ou une plante imaginaire.
Une hypothèse de localisation doit donc rester une hypothèse jusqu’à sa vérification par des sources indépendantes. Dans un usage professionnel, chaque indice doit être observable, documenté et reproductible. Sans cette discipline, l’IA ne produit pas du renseignement : elle produit une histoire convaincante.
Le faux dossier est parfois aussi dangereux que le vrai
La synthèse automatique ajoute une autre fragilité. En rapprochant des pseudonymes, des horaires ou des relations, le modèle peut faire apparaître un schéma réel. Il peut aussi fusionner deux personnes portant le même nom, attribuer une photographie au mauvais compte ou transformer une corrélation en certitude.
Pour la personne visée, l’erreur n’est pas nécessairement rassurante. Un dossier composé de 80 % de faits exacts et de 20 % d’inventions peut suffire à orienter une fraude, une campagne de harcèlement, une décision de recrutement ou une accusation. Plus la présentation est fluide, plus le lecteur risque d’oublier que le texte résume des sources de qualité inégale.
Il faut donc distinguer trois couches : ce qui est directement observé, ce qui est recoupé et ce qui est seulement inféré. Un système sérieux indique ses sources, conserve les contradictions et exprime l’incertitude. Un chatbot grand public tend au contraire à lisser les trous pour fournir une réponse agréable à lire.
Le même outil sert l’enquête et l’attaque
Un journaliste peut employer ces capacités pour retrouver l’origine d’une image. Une équipe de sécurité peut cartographier l’exposition publique de son organisation. Une personne peut auditer sa propre empreinte. Les mêmes fonctions peuvent servir à préparer une usurpation, repérer une routine ou choisir le prétexte d’un message frauduleux.
La différence se trouve dans l’autorisation, la finalité, la proportionnalité et le traitement des données — pas dans l’outil. C’est pourquoi les garde-fous intégrés aux modèles ne peuvent pas résoudre seuls le problème. Une requête apparemment anodine peut faire partie d’une enquête légitime ou d’une opération hostile ; un refus peut parfois bloquer le professionnel sans arrêter un acteur disposant d’un autre modèle ou d’un service spécialisé.
Le National Cyber Security Centre britannique estime que l’IA améliore déjà la reconnaissance des victimes, l’ingénierie sociale et le traitement rapide de données volées. Il prévoit surtout une augmentation de l’efficacité et du volume de techniques existantes, plutôt que l’apparition soudaine d’une attaque entièrement nouvelle. Europol fait le même constat : les modèles génératifs rendent les escroqueries plus adaptées au contexte culturel et aux informations personnelles de la cible.
Autrement dit, le danger le plus proche n’est pas une superintelligence omnisciente. C’est une vieille fraude devenue plus attentive, mieux écrite et beaucoup moins chère.
Faire l’audit de son propre reflet numérique
Réduire son exposition commence par un inventaire, pas par la panique. L’objectif n’est pas de disparaître — promesse irréaliste — mais de comprendre quelles pièces peuvent être assemblées.
- Cherchez votre nom, ses variantes, vos pseudonymes habituels et les adresses électroniques que vous utilisez publiquement. Faites-le dans les langues et alphabets pertinents, en navigation déconnectée lorsque c’est possible.
- Examinez les résultats comme un inconnu : permettent-ils de relier domicile, emploi, entourage, horaires, déplacements, loisirs ou périodes d’absence ?
- Vérifiez les photographies originales avant publication. Le décor, un reflet, une plaque, un badge, un colis ou une vue depuis une fenêtre peuvent être plus révélateurs que le sujet principal. Supprimez les métadonnées de localisation lorsqu’elles ne sont pas utiles.
- Évitez de réutiliser partout le même pseudonyme et la même adresse électronique. Séparer les usages professionnel, administratif, commercial et public limite les rapprochements automatiques.
- Fermez les anciens comptes, corrigez les profils obsolètes et demandez le retrait des informations qui n’ont plus de raison d’être publiques.
En Belgique et dans l’Union européenne, le droit à l’effacement n’est pas absolu, mais il offre des leviers concrets. L’Autorité de protection des données explique la désindexation et recommande de contacter d’abord l’éditeur ou la source, puis le moteur de recherche. Une désindexation ne supprime pas toujours le contenu d’origine ; elle réduit cependant sa visibilité lors d’une recherche sur le nom.
Il est utile de répéter cet audit. Un résultat supprimé peut avoir été copié, une plateforme peut modifier ses paramètres et une nouvelle fuite peut relier des éléments jusque-là séparés. La sécurité de l’identité numérique est un entretien, pas un grand nettoyage effectué une seule fois.
Ne plus juger un message à sa grammaire
Les fautes grossières ne sont plus un filtre fiable. Un message frauduleux peut être parfaitement écrit, adapté à la langue du destinataire et enrichi de détails exacts. La bonne question n’est donc plus « ce message a-t-il l’air professionnel ? », mais « cette demande était-elle attendue et puis-je la vérifier ailleurs ? ».
Une demande urgente de paiement, de document, de code ou de connexion doit être contrôlée par un canal déjà connu : l’application officielle, un numéro enregistré ou une conversation distincte. Ne répondez pas au message pour demander s’il est authentique et n’utilisez pas le numéro qu’il fournit. Pour les demandes sensibles entre proches ou collègues, un mot convenu hors ligne peut aussi empêcher une imitation convaincante de suffire.
Activez l’authentification multifacteur, en commençant par la messagerie principale. Safeonweb recommande la 2FA, des mots de passe distincts et un gestionnaire de mots de passe. En cas de message suspect, la plateforme belge conseille de ne pas suivre le lien, de vérifier via le site ou le numéro officiel et de transférer le message à suspect@safeonweb.be.
Les organisations doivent protéger le contexte, pas seulement les comptes
Une entreprise peut sécuriser sa messagerie tout en publiant l’organigramme, les fournisseurs, les déplacements, les projets, les signatures et les habitudes qui rendent une usurpation crédible. La réduction du risque ne signifie pas supprimer toute transparence. Elle consiste à examiner ce que plusieurs publications permettent de déduire ensemble.
Les équipes devraient cartographier les informations exposées par fonction, inclure des scénarios réellement personnalisés dans les exercices de sensibilisation et imposer une vérification indépendante pour les paiements, changements de coordonnées bancaires, exports de données et demandes urgentes de dirigeants. Les annuaires publics doivent révéler ce qui est nécessaire, pas servir de base prête à l’emploi pour le ciblage.
Elles doivent aussi encadrer leur propre usage de l’IA. Copier dans un service grand public une liste de salariés, un dossier client ou des données collectées pendant une enquête peut créer une nouvelle divulgation. Un audit défensif reste un traitement de données : il a besoin d’un objectif, d’un périmètre, d’un accès limité, d’une durée de conservation et d’une validation humaine.
Ce qui change vraiment
L’IA n’a pas aboli l’anonymat en un jour. Elle a rendu beaucoup plus facile l’assemblage de fragments que les internautes, leurs proches, leurs employeurs et leurs appareils publiaient déjà. Sa force n’est pas de tout savoir, mais de savoir où regarder, quoi rapprocher et comment présenter le résultat de façon convaincante.
Cette nuance conduit à une défense plus réaliste. Il ne s’agit pas de renoncer à toute présence en ligne, ni de croire qu’un bouton effacera le passé. Il s’agit de réduire les ponts inutiles entre nos différentes vies, de vérifier les demandes plutôt que leur style, et de considérer chaque publication non seulement pour ce qu’elle dit aujourd’hui, mais pour ce qu’une machine pourra en déduire demain.
Informations éditoriales
- Rédaction
- Jeremy Kraft
- Dernière vérification
- Méthode
- Sources publiques, vérification éditoriale et conseils proportionnés.


Discussion
Commentaires
Aucun commentaire pour le moment. Vous pouvez ouvrir la discussion avec une question ou un retour d’expérience.